diff --git a/chapters/mr/chapter 0/1.mdx b/chapters/mr/chapter 0/1.mdx
new file mode 100644
index 000000000..b0b6b4319
--- /dev/null
+++ b/chapters/mr/chapter 0/1.mdx
@@ -0,0 +1,51 @@
+# परिचय[[introduction]]
+
+हगिंग फेस (Hugging Face) कोर्समध्ये आपले स्वागत आहे! हा परिचय तुम्हाला तुमचे वर्किंग एन्व्हायर्नमेंट (working environment) सेट करण्यासाठी मार्गदर्शन करेल. जर तुम्ही हा कोर्स नुकताच सुरू करत असाल, तर आम्ही शिफारस करतो की तुम्ही आधी [प्रकरण १](/course/chapter1) पहावे, आणि नंतर परत येऊन तुमचे एन्व्हायर्नमेंट सेट करावे म्हणजे तुम्ही स्वतः कोड चालवून पाहू शकाल.
+
+या कोर्समध्ये आपण वापरणार असलेल्या सर्व लायब्ररीज पायथन पॅकेजेस (Python packages) म्हणून उपलब्ध आहेत, त्यामुळे आपण येथे पायथन एन्व्हायर्नमेंट कसे सेट करायचे आणि आवश्यक असलेल्या विशिष्ट लायब्ररीज कशा इन्स्टॉल करायच्या हे पाहणार आहोत.
+
+आपण तुमचे वर्किंग एन्व्हायर्नमेंट सेट करण्याच्या दोन पद्धती पाहणार आहोत: कोलॅब नोटबुक (Colab notebook) वापरणे किंवा पायथन व्हर्च्युअल एन्व्हायर्नमेंट (Python virtual environment) वापरणे. तुम्हाला सर्वात योग्य वाटेल अशी पद्धत तुम्ही निवडू शकता. नवशिक्यांसाठी (beginners), आम्ही कोलॅब नोटबुक वापरून सुरुवात करण्याची जोरदार शिफारस करतो.
+
+लक्षात घ्या की आपण विंडोज सिस्टीम कव्हर करणार नाही आहोत. जर तुम्ही विंडोज वापरत असाल, तर आम्ही तुम्हाला कोलॅब नोटबुक वापरूनच हा कोर्स पुढे चालू ठेवण्याची शिफारस करतो. जर तुम्ही लिनक्स (Linux) डिस्ट्रिब्युशन किंवा मॅकओएस (macOS) वापरत असाल, तर तुम्ही येथे वर्णन केलेल्या दोनपैकी कोणतीही पद्धत वापरू शकता.
+
+कोर्सचा बहुतांश भाग तुमच्याकडे हगिंग फेस अकाउंट असण्यावर अवलंबून आहे. आम्ही आताच एक तयार करण्याची शिफारस करतो: [खाते तयार करा](https://huggingface.co/join).
+
+## गुगल कोलॅब नोटबुक वापरणे[[using-a-google-colab-notebook]]
+
+कोलॅब नोटबुक वापरणे हा सर्वात सोपा सेटअप आहे; तुमच्या ब्राउझरमध्ये नोटबुक सुरू करा आणि थेट कोडिंगला लागा!
+
+जर तुम्हाला कोलॅबची माहिती नसेल, तर आम्ही [परिचय](https://colab.research.google.com/notebooks/intro.ipynb) वाचून सुरुवात करण्याची शिफारस करतो. कोलॅब तुम्हाला GPU किंवा TPU सारखे काही प्रवेगक हार्डवेअर (accelerating hardware) वापरण्याची परवानगी देते, आणि ते लहान वर्कलोड्ससाठी मोफत आहे.
+
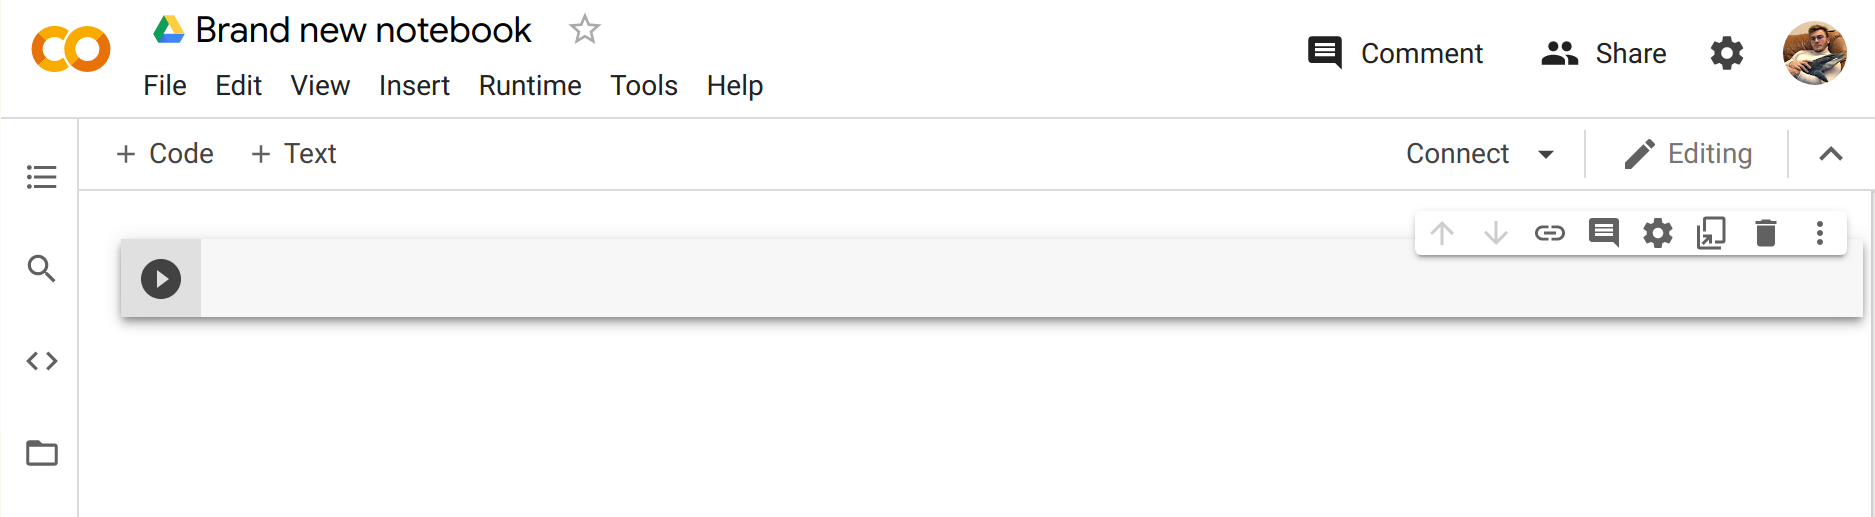
+एकदा तुम्हाला कोलॅबची चांगली ओळख झाल्यावर, नवीन नोटबुक तयार करा आणि सेटअपला सुरुवात करा:
+
+
+
+
+
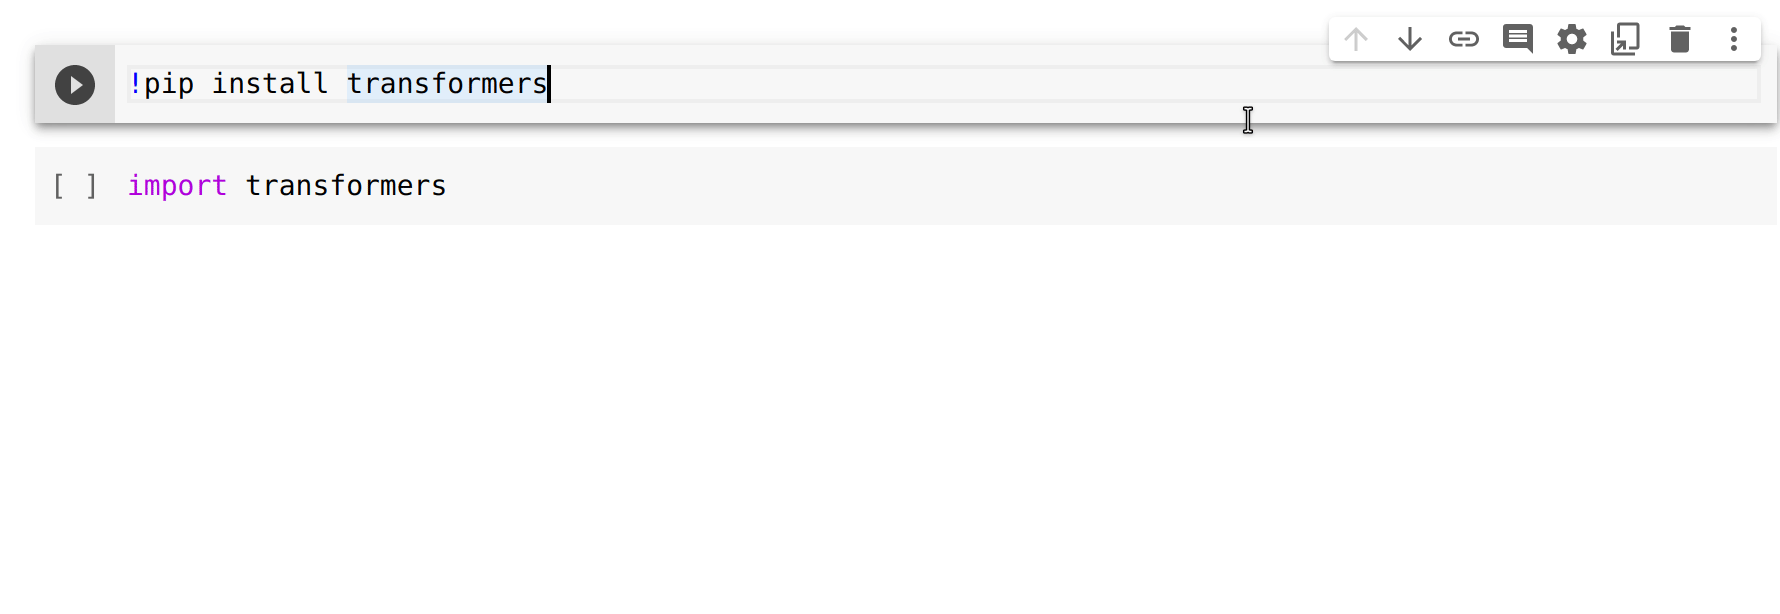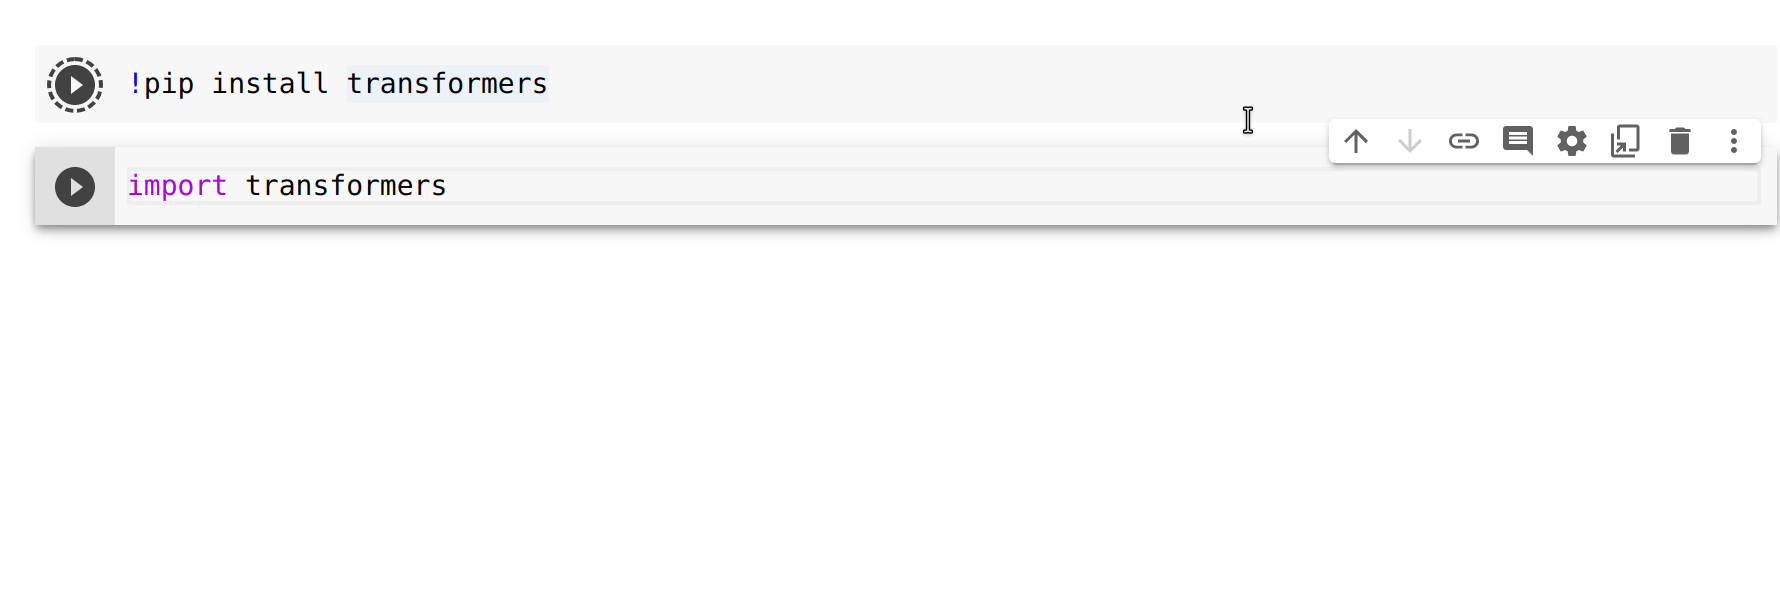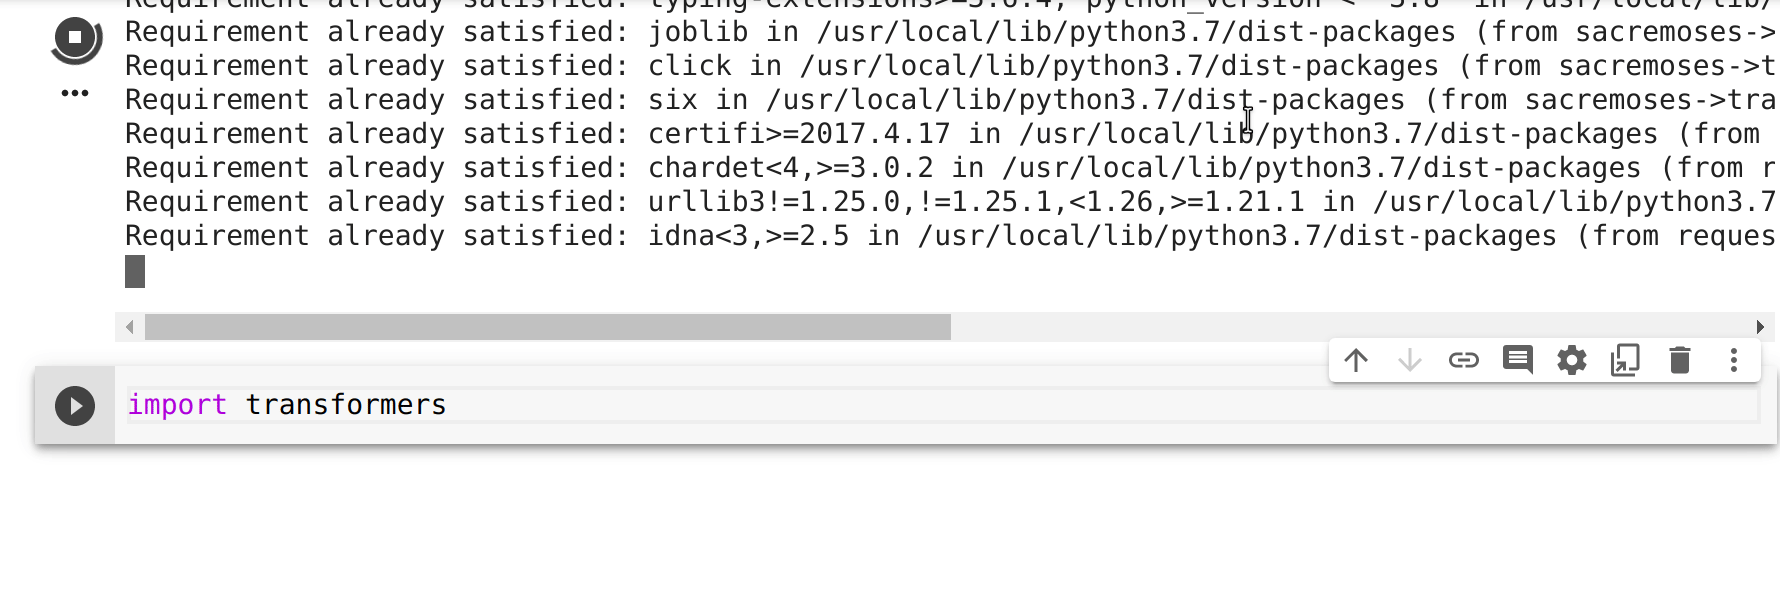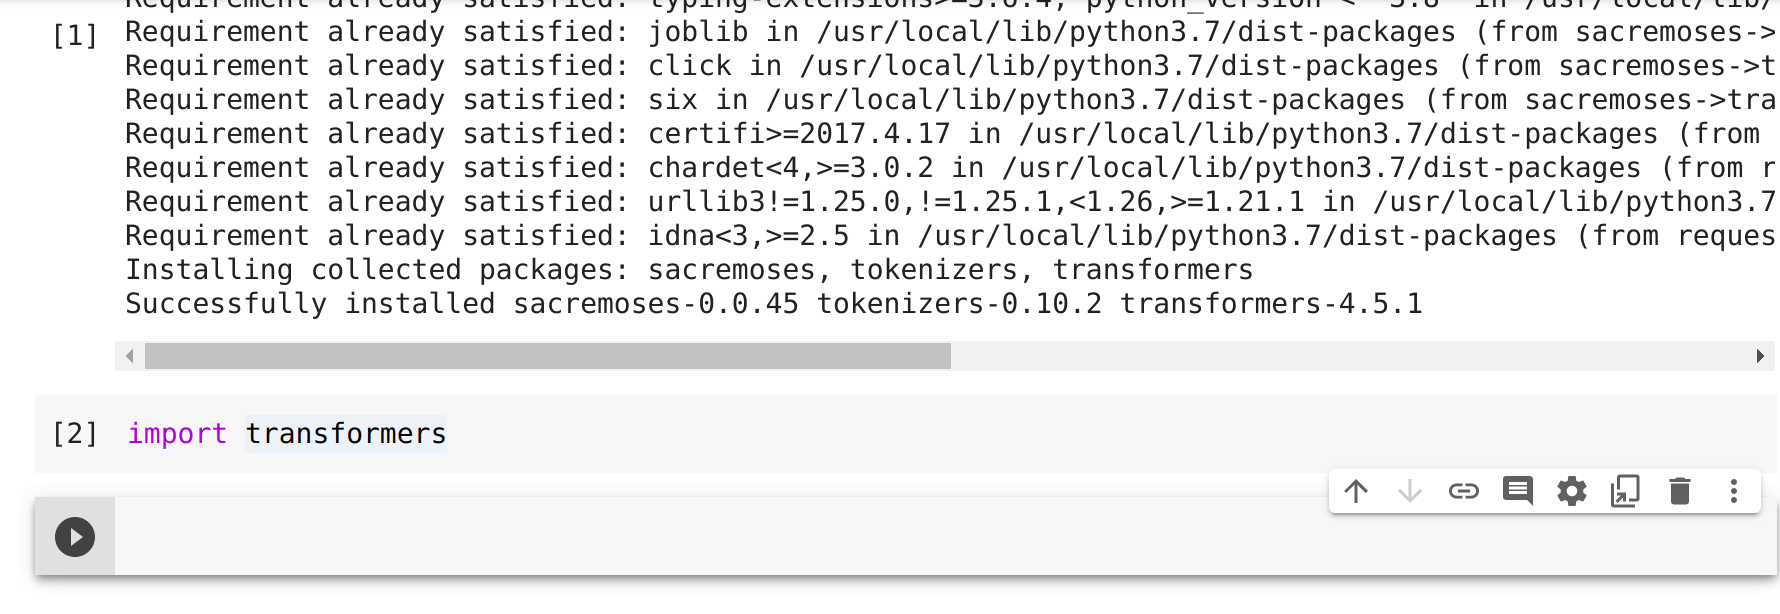
+पुढची पायरी म्हणजे या कोर्समध्ये आपण ज्या लायब्ररीज वापरणार आहोत त्या इन्स्टॉल करणे. आपण इन्स्टॉलेशनसाठी `pip` वापरू, जे पायथनसाठी पॅकेज मॅनेजर आहे. नोटबुक्समध्ये, तुम्ही सिस्टीम कमांड्सच्या आधी `!` चिन्ह लावून त्या रन करू शकता, जेणेकरून तुम्ही 🤗 ट्रान्सफॉर्मर्स (Transformers) लायब्ररी खालीलप्रमाणे इन्स्टॉल करू शकाल:
+तुम्ही तुमच्या पायथन रनटाइममध्ये पॅकेज इम्पोर्ट (import) करून ते योग्यरीत्या इन्स्टॉल झाले आहे की नाही याची खात्री करू शकता:
+
+

+
+
+यामुळे 🤗 ट्रान्सफॉर्मर्सची अतिशय हलकी (light) आवृत्ती इन्स्टॉल होते. विशेषतः, कोणतेही विशिष्ट मशीन लर्निंग फ्रेमवर्क (जसे की PyTorch किंवा TensorFlow) यात इन्स्टॉल केलेले नाहीत. आपण या लायब्ररीची बरीच वेगळी वैशिष्ट्ये वापरणार असल्याने, आम्ही डेव्हलपमेंट व्हर्जन (development version) इन्स्टॉल करण्याची शिफारस करतो, जे जवळजवळ कोणत्याही संभाव्य युज केससाठी (use case) सर्व आवश्यक डिपेंडन्सीज (dependencies) सोबत येते:
+यासाठी थोडा वेळ लागेल, पण त्यानंतर तुम्ही उर्वरित कोर्ससाठी सज्ज व्हाल!
+
+## पायथन व्हर्च्युअल एन्व्हायर्नमेंट वापरणे[[using-a-python-virtual-environment]]
+
+जर तुम्ही पायथन व्हर्च्युअल एन्व्हायर्नमेंट वापरण्यास प्राधान्य देत असाल, तर पहिली पायरी म्हणजे तुमच्या सिस्टीमवर पायथन इन्स्टॉल करणे. सुरुवातीसाठी आम्ही [या मार्गदर्शकाचे](https://realpython.com/installing-python/) पालन करण्याची शिफारस करतो.
+
+एकदा तुम्ही पायथन इन्स्टॉल केल्यानंतर, तुम्ही तुमच्या टर्मिनलमध्ये पायथन कमांड्स चालवू शकाल. पुढील पायऱ्यांवर जाण्यापूर्वी ते योग्यरीत्या इन्स्टॉल झाले आहे याची खात्री करण्यासाठी तुम्ही खालील कमांड रन करून सुरुवात करू शकता: `python --version`. हे तुमच्या सिस्टीमवर आता उपलब्ध असलेली पायथन आवृत्ती प्रिंट करेल.
+
+जेव्हा तुम्ही तुमच्या टर्मिनलमध्ये एखादी पायथन कमांड चालवता, जसे की `python --version`, तेव्हा तुम्ही तुमच्या सिस्टीमवरील "मुख्य" (main) पायथन म्हणून तुमची कमांड चालवणाऱ्या प्रोग्रामचा विचार केला पाहिजे. आम्ही शिफारस करतो की हे मुख्य इन्स्टॉलेशन कोणत्याही पॅकेजेसपासून मुक्त ठेवा, आणि तुम्ही काम करत असलेल्या प्रत्येक ॲप्लिकेशनसाठी वेगळे एन्व्हायर्नमेंट तयार करण्यासाठी त्याचा वापर करा — अशा प्रकारे, प्रत्येक ॲप्लिकेशनच्या स्वतःच्या डिपेंडन्सीज आणि पॅकेजेस असू शकतात आणि तुम्हाला इतर ॲप्लिकेशन्ससोबतच्या संभाव्य कंपॅटिबिलिटीच्या (compatibility) समस्यांबद्दल काळजी करण्याची गरज नाही.
+
+पायथनमध्ये हे [*व्हर्च्युअल एन्व्हायर्नमेंट्स*](https://docs.python.org/3/tutorial/venv.html) द्वारे केले जाते, जे सेल्फ-कंटेंड (self-contained) डिरेक्टरी ट्रीज (directory trees) आहेत ज्यात प्रत्येक डिरेक्टरीमध्ये एका विशिष्ट पायथन आवृत्तीसोबतच ॲप्लिकेशनला आवश्यक असलेली सर्व पॅकेजेस इन्स्टॉल केलेली असतात. असे व्हर्च्युअल एन्व्हायर्नमेंट तयार करणे अनेक वेगवेगळ्या टूल्सद्वारे केले जाऊ शकते, परंतु आपण त्या हेतूसाठी अधिकृत पायथन पॅकेज वापरू, ज्याला [`venv`](https://docs.python.org/3/library/venv.html#module-venv) म्हटले जाते.
+
+प्रथम, तुम्हाला तुमचे ॲप्लिकेशन ज्या डिरेक्टरीमध्ये ठेवायचे आहे ती डिरेक्टरी तयार करा — उदाहरणार्थ, तुम्हाला तुमच्या होम डिरेक्टरीच्या रूटमध्ये *transformers-course* नावाची नवीन डिरेक्टरी तयार करावीशी वाटेल:
+या डिरेक्टरीच्या आतून, पायथनचे `venv` मॉड्युल वापरून व्हर्च्युअल एन्व्हायर्नमेंट तयार करा:
+आता तुमच्या अन्यथा रिकाम्या असलेल्या फोल्डरमध्ये *.env* नावाची डिरेक्टरी असायला हवी:
+```out
+. .. .env
+तुम्ही which python कमांड चालवून एन्व्हायर्नमेंट ॲक्टिव्हेट (activate) झाले आहे की नाही याची खात्री करू शकता: जर ते व्हर्च्युअल एन्व्हायर्नमेंटकडे निर्देशित करत असेल, तर तुम्ही ते यशस्वीरीत्या ॲक्टिव्हेट केले आहे!
+डिपेंडन्सी इन्स्टॉल करणे[[installing-dependencies]]
+गुगल कोलॅब इन्स्टन्सेस वापरण्याच्या मागील विभागाप्रमाणेच, आता तुम्हाला पुढे जाण्यासाठी आवश्यक असलेली पॅकेजेस इन्स्टॉल करावी लागतील. पुन्हा एकदा, तुम्ही pip पॅकेज मॅनेजर वापरून 🤗 ट्रान्सफॉर्मर्सचे डेव्हलपमेंट व्हर्जन इन्स्टॉल करू शकता:
\ No newline at end of file
diff --git a/chapters/mr/chapter 1/1.mdx b/chapters/mr/chapter 1/1.mdx
new file mode 100644
index 000000000..473b0e1ef
--- /dev/null
+++ b/chapters/mr/chapter 1/1.mdx
@@ -0,0 +1,105 @@
+# परिचय[[introduction]]
+
+
+
+## 🤗 कोर्समध्ये आपले स्वागत आहे![[welcome-to-the-course]]
+
+
+
+हा कोर्स तुम्हाला [हगिंग फेस (Hugging Face)](https://huggingface.co/) इकोसिस्टिमच्या लायब्ररीज — [🤗 Transformers](https://github.com/huggingface/transformers), [🤗 Datasets](https://github.com/huggingface/datasets), [🤗 Tokenizers](https://github.com/huggingface/tokenizers), आणि [🤗 Accelerate](https://github.com/huggingface/accelerate) — तसेच [हगिंग फेस हब (Hugging Face Hub)](https://huggingface.co/models) चा वापर करून लार्ज लँग्वेज मॉडेल्स (LLMs) आणि नॅचरल लँग्वेज प्रोसेसिंग (NLP) बद्दल शिकवेल.
+
+आपण हगिंग फेस इकोसिस्टिमच्या बाहेरील लायब्ररीज देखील कव्हर करू. हे एआय (AI) कम्युनिटीसाठी अद्भुत योगदान आणि आश्चर्यकारकपणे उपयुक्त टूल्स आहेत.
+
+हे पूर्णपणे मोफत आणि जाहिरातींविना आहे.
+
+## NLP आणि LLMs समजून घेणे[[understanding-nlp-and-llms]]
+
+जरी हा कोर्स मूळतः NLP (नॅचरल लँग्वेज प्रोसेसिंग) वर केंद्रित असला, तरी आता तो लार्ज लँग्वेज मॉडेल्स (LLMs) वर भर देण्यासाठी विकसित झाला आहे, जे या क्षेत्रातील नवीनतम प्रगती दर्शवतात.
+
+**फरक काय आहे?**
+- **NLP (नॅचरल लँग्वेज प्रोसेसिंग)** हे संगणकांना मानवी भाषा समजून घेण्यास, अर्थ लावण्यास आणि तयार करण्यास सक्षम करण्यावर केंद्रित एक व्यापक क्षेत्र आहे. NLP मध्ये सेंटिमेंट ॲनालिसिस (sentiment analysis), नेम्ड एंटिटी रेकग्निशन (named entity recognition) आणि मशीन ट्रान्सलेशन (machine translation) यांसारख्या अनेक तंत्रांचा आणि कार्यांचा समावेश होतो.
+- **LLMs (लार्ज लँग्वेज मॉडेल्स)** हा NLP मॉडेल्सचा एक शक्तिशाली उपसंच आहे जो त्यांच्या विशाल आकार, विस्तृत ट्रेनिंग डेटा आणि कमीत कमी टास्क-विशिष्ट ट्रेनिंगसह अनेक प्रकारची भाषिक कार्ये करण्याच्या क्षमतेसाठी ओळखला जातो. Llama, GPT, किंवा Claude सिरीजसारखी मॉडेल्स LLMs ची उदाहरणे आहेत ज्यांनी NLP मध्ये काय शक्य आहे यात क्रांती घडवून आणली आहे.
+
+या संपूर्ण कोर्समध्ये, तुम्ही पारंपारिक NLP संकल्पना आणि अत्याधुनिक LLM तंत्रे या दोन्ही गोष्टींबद्दल शिकाल, कारण LLMs सोबत प्रभावीपणे काम करण्यासाठी NLP चा पाया समजून घेणे महत्त्वाचे आहे.
+
+## काय अपेक्षा करावी?[[what-to-expect]]
+
+येथे कोर्सचा थोडक्यात आढावा आहे:
+
+
+

+

+
+
+- प्रकरणे १ ते ४ 🤗 Transformers लायब्ररीच्या मुख्य संकल्पनांचा परिचय देतात. कोर्सच्या या भागाच्या शेवटी, तुम्हाला ट्रान्सफॉर्मर मॉडेल्स कसे काम करतात याची माहिती होईल आणि [हगिंग फेस हब](https://huggingface.co/models) मधील मॉडेल कसे वापरायचे, डेटासेटवर ते फाइन-ट्यून (fine-tune) कसे करायचे आणि हबवर तुमचे निकाल कसे शेअर करायचे हे समजेल!
+- प्रकरणे ५ ते ८ क्लासिक NLP टास्क आणि LLM तंत्रांमध्ये जाण्यापूर्वी 🤗 Datasets आणि 🤗 Tokenizers च्या मूलभूत गोष्टी शिकवतात. या भागाच्या शेवटी, तुम्ही लँग्वेज प्रोसेसिंगमधील सर्वात सामान्य आव्हानांना स्वतःहून सामोरे जाण्यास सक्षम व्हाल.
+- प्रकरण ९ NLP च्या पलीकडे जाऊन 🤗 हबवर तुमच्या मॉडेल्सचे डेमो (demos) कसे बनवायचे आणि शेअर कसे करायचे हे कव्हर करते. या भागाच्या शेवटी, तुम्ही तुमचे 🤗 Transformers ॲप्लिकेशन जगासमोर प्रदर्शित करण्यासाठी तयार असाल!
+- प्रकरणे १० ते १२ फाइन-ट्युनिंग (fine-tuning), उच्च-गुणवत्तेचे डेटासेट क्युरेट करणे आणि रिझनिंग मॉडेल्स (reasoning models) तयार करणे यासारख्या प्रगत LLM विषयांवर सखोल माहिती देतात.
+
+हा कोर्स:
+
+* पायथनचे (Python) चांगले ज्ञान असणे आवश्यक आहे.
+* परिचयात्मक डीप लर्निंग कोर्स (deep learning course) केल्यानंतर घेणे अधिक चांगले राहील, जसे की [fast.ai चा](https://www.fast.ai/) [प्रॅक्टिकल डीप लर्निंग फॉर कोडर्स](https://course.fast.ai/) किंवा [DeepLearning.AI](https://www.deeplearning.ai/) ने विकसित केलेल्या प्रोग्राम्सपैकी एखादा.
+* आधीच्या [PyTorch](https://pytorch.org/) किंवा [TensorFlow](https://www.tensorflow.org/) ज्ञानाची अपेक्षा करत नाही, तरीही यापैकी एकाची थोडी माहिती असल्यास मदत होईल.
+
+तुम्ही हा कोर्स पूर्ण केल्यानंतर, आम्ही DeepLearning.AI च्या [नॅचरल लँग्वेज प्रोसेसिंग स्पेशलायझेशन](https://www.coursera.org/specializations/natural-language-processing?utm_source=deeplearning-ai&utm_medium=institutions&utm_campaign=20211011-nlp-2-hugging_face-page-nlp-refresh) कडे पाहण्याची शिफारस करतो, ज्यामध्ये नेव्ह बेज (naive Bayes) आणि LSTM सारख्या पारंपरिक NLP मॉडेल्सची विस्तृत श्रेणी समाविष्ट आहे, ज्यांच्याबद्दल जाणून घेणे नक्कीच फायदेशीर आहे!
+
+## आम्ही कोण आहोत?[[who-are-we]]
+
+लेखकांबद्दल:
+
+[**Abubakar Abid**](https://huggingface.co/abidlabs) यांनी स्टॅनफोर्ड (Stanford) मधून अप्लाइड मशीन लर्निंगमध्ये पीएचडी पूर्ण केली आहे. त्यांच्या पीएचडी दरम्यान, त्यांनी [Gradio](https://github.com/gradio-app/gradio) ची स्थापना केली, जी एक ओपन-सोर्स पायथन लायब्ररी आहे जिचा वापर 600,000 पेक्षा जास्त मशीन लर्निंग डेमो बनवण्यासाठी केला गेला आहे. Gradio ला हगिंग फेसने अधिग्रहित केले आहे, जिथे अबुबकर आता मशीन लर्निंग टीम लीड म्हणून काम करत आहेत.
+
+[**Ben Burtenshaw**](https://huggingface.co/burtenshaw) हे हगिंग फेसमध्ये मशीन लर्निंग इंजिनिअर आहेत. त्यांनी अँटवर्प विद्यापीठातून (University of Antwerp) नॅचरल लँग्वेज प्रोसेसिंगमध्ये पीएचडी पूर्ण केली, जिथे त्यांनी साक्षरता कौशल्ये सुधारण्याच्या उद्देशाने मुलांसाठी कथा तयार करण्यासाठी ट्रान्सफॉर्मर मॉडेल्स लागू केली. तेव्हापासून, त्यांनी व्यापक समुदायासाठी शैक्षणिक साहित्य आणि टूल्सवर लक्ष केंद्रित केले आहे.
+
+[**Matthew Carrigan**](https://huggingface.co/Rocketknight1) हे हगिंग फेसमध्ये मशीन लर्निंग इंजिनिअर आहेत. ते डब्लिन, आयर्लंडमध्ये राहतात आणि त्यांनी यापूर्वी Parse.ly मध्ये एमएल (ML) इंजिनिअर म्हणून आणि त्याआधी ट्रिनिटी कॉलेज डब्लिनमध्ये पोस्ट-डॉक्टोरल संशोधक म्हणून काम केले आहे. सध्याचे आर्किटेक्चर्स स्केल करून आपण AGI पर्यंत पोहोचू यावर त्यांचा विश्वास नाही, परंतु तरीही त्यांना रोबोट अमरत्वाविषयी (robot immortality) मोठ्या आशा आहेत.
+
+[**Lysandre Debut**](https://huggingface.co/lysandre) हे हगिंग फेसमध्ये मशीन लर्निंग इंजिनिअर आहेत आणि अगदी सुरुवातीच्या विकास टप्प्यांपासून 🤗 Transformers लायब्ररीवर काम करत आहेत. अत्यंत साध्या API सह टूल्स विकसित करून NLP प्रत्येकासाठी प्रवेशयोग्य (accessible) बनवणे हे त्यांचे ध्येय आहे.
+
+[**Sylvain Gugger**](https://huggingface.co/sgugger) हे हगिंग फेसमध्ये रिसर्च इंजिनिअर आहेत आणि 🤗 Transformers लायब्ररीच्या कोअर मेंटेनर्सपैकी एक आहेत. यापूर्वी ते fast.ai येथे रिसर्च सायंटिस्ट होते, आणि त्यांनी जेरेमी हॉवर्डसोबत _[Deep Learning for Coders with fastai and PyTorch](https://learning.oreilly.com/library/view/deep-learning-for/9781492045519/)_ चे सह-लेखन केले. त्यांच्या संशोधनाचा मुख्य भर मर्यादित संसाधनांवर मॉडेल्स वेगाने ट्रेन करण्यासाठी तंत्रे डिझाइन करणे आणि सुधारणे यावर आहे, ज्यामुळे डीप लर्निंग अधिक सुलभ होईल.
+
+[**Dawood Khan**](https://huggingface.co/dawoodkhan82) हे हगिंग फेसमध्ये मशीन लर्निंग इंजिनिअर आहेत. ते NYC चे आहेत आणि त्यांनी न्यूयॉर्क विद्यापीठातून संगणक विज्ञानात (Computer Science) पदवी प्राप्त केली आहे. काही वर्षे iOS इंजिनिअर म्हणून काम केल्यानंतर, दाऊद यांनी त्यांच्या सह-संस्थापकांसोबत Gradio सुरू करण्यासाठी नोकरी सोडली. शेवटी Gradio ला हगिंग फेसने अधिग्रहित केले.
+
+[**Merve Noyan**](https://huggingface.co/merve) या हगिंग फेसमध्ये डेव्हलपर ॲडव्होकेट (developer advocate) आहेत, ज्या सर्वांसाठी मशीन लर्निंगचे लोकशाहीकरण करण्यासाठी टूल्स विकसित करण्यावर आणि त्यांच्याभोवती कंटेंट तयार करण्यावर काम करत आहेत.
+
+[**Lucile Saulnier**](https://huggingface.co/SaulLu) या हगिंग फेसमध्ये मशीन लर्निंग इंजिनिअर आहेत, ज्या ओपन सोर्स टूल्स विकसित आणि समर्थित करतात. त्या नॅचरल लँग्वेज प्रोसेसिंग क्षेत्रातील अनेक संशोधन प्रकल्पांमध्ये जसे की कोलॅबोरेटिव्ह ट्रेनिंग (collaborative training) आणि BigScience मध्ये सक्रियपणे सामील आहेत.
+
+[**Lewis Tunstall**](https://huggingface.co/lewtun) हे हगिंग फेसमध्ये मशीन लर्निंग इंजिनिअर आहेत, ज्यांचे लक्ष ओपन-सोर्स टूल्स विकसित करणे आणि ती व्यापक समुदायासाठी प्रवेशयोग्य (accessible) बनवणे यावर आहे. ते O'Reilly च्या [Natural Language Processing with Transformers](https://www.oreilly.com/library/view/natural-language-processing/9781098136789/) पुस्तकाचे सह-लेखक देखील आहेत.
+
+[**Leandro von Werra**](https://huggingface.co/lvwerra) हे हगिंग फेसच्या ओपन-सोर्स टीममध्ये मशीन लर्निंग इंजिनिअर आहेत आणि O'Reilly च्या [Natural Language Processing with Transformers](https://www.oreilly.com/library/view/natural-language-processing/9781098136789/) पुस्तकाचे सह-लेखक देखील आहेत. संपूर्ण मशीन लर्निंग स्टॅकमध्ये काम करून NLP प्रकल्प प्रॉडक्शनमध्ये (production) आणण्याचा त्यांच्याकडे अनेक वर्षांचा उद्योगातील अनुभव आहे.
+
+## नेहमी विचारले जाणारे प्रश्न (FAQ)[[faq]]
+
+नेहमी विचारल्या जाणाऱ्या प्रश्नांची काही उत्तरे येथे आहेत:
+
+- **हा कोर्स केल्यास प्रमाणपत्र (certification) मिळेल का?**
+सध्या आमच्याकडे या कोर्ससाठी कोणतेही प्रमाणपत्र नाही. तथापि, आम्ही हगिंग फेस इकोसिस्टिमसाठी एका प्रमाणीकरण प्रोग्रामवर काम करत आहोत -- संपर्कात रहा!
+
+- **मी या कोर्ससाठी किती वेळ द्यावा?**
+या कोर्समधील प्रत्येक प्रकरण १ आठवड्यात पूर्ण करण्याच्या उद्देशाने डिझाइन केले आहे, ज्यासाठी आठवड्याला सुमारे ६-८ तास काम करावे लागेल. तथापि, कोर्स पूर्ण करण्यासाठी तुम्ही तुम्हाला हवा तितका वेळ घेऊ शकता.
+
+- **जर मला काही प्रश्न असेल तर मी तो कुठे विचारू शकतो?**
+जर तुम्हाला कोर्सच्या कोणत्याही विभागाबद्दल प्रश्न असेल, तर पृष्ठाच्या शीर्षस्थानी असलेल्या "*Ask a question*" (प्रश्न विचारा) बॅनरवर क्लिक करा जेणेकरून तुम्ही थेट [हगिंग फेस फोरम्स (Hugging Face forums)](https://discuss.huggingface.co/) च्या योग्य विभागात पुनर्निर्देशित (redirected) व्हाल:
+
+
+
+लक्षात घ्या की कोर्स पूर्ण केल्यानंतर जर तुम्हाला अधिक सराव करायचा असेल तर फोरमवर [प्रोजेक्ट आयडियाज (project ideas)](https://discuss.huggingface.co/c/course/course-event/25) ची यादी देखील उपलब्ध आहे.
+
+- **मला कोर्ससाठीचा कोड कुठे मिळेल?**
+प्रत्येक विभागासाठी, Google Colab किंवा Amazon SageMaker Studio Lab मध्ये कोड चालवण्यासाठी (run) पृष्ठाच्या शीर्षस्थानी असलेल्या बॅनरवर क्लिक करा:
+
+
+
+कोर्समधील सर्व कोड असलेल्या ज्युपिटर नोटबुक्स (Jupyter notebooks) [`huggingface/notebooks`](https://github.com/huggingface/notebooks) रेपोवर होस्ट केलेल्या आहेत. जर तुम्हाला त्या लोकली जनरेट करायच्या असतील, तर GitHub वरील [`course`](https://github.com/huggingface/course#-jupyter-notebooks) रेपो मधील सूचना पहा.
+
+- **मी कोर्समध्ये कसे योगदान देऊ शकतो?**
+कोर्समध्ये योगदान देण्याचे अनेक मार्ग आहेत! जर तुम्हाला एखादी टायपो (typo) किंवा बग (bug) आढळल्यास, कृपया [`course`](https://github.com/huggingface/course) रेपोवर एखादा इश्यू (issue) ओपन करा. जर तुम्हाला हा कोर्स तुमच्या मातृभाषेत अनुवादित करण्यात मदत करायची असेल, तर [येथे](https://github.com/huggingface/course#translating-the-course-into-your-language) दिलेल्या सूचना पहा.
+
+- **प्रत्येक भाषांतरासाठी कोणत्या निवडी केल्या गेल्या?**
+प्रत्येक भाषांतरासाठी एक शब्दकोष (glossary) आणि `TRANSLATING.txt` फाईल असते ज्यामध्ये मशीन लर्निंगमधील तांत्रिक शब्दांसाठी (jargon) केलेल्या निवडींचा तपशील दिलेला असतो. तुम्ही जर्मन भाषेसाठी एक उदाहरण [येथे](https://github.com/huggingface/course/blob/main/chapters/de/TRANSLATING.txt) शोधू शकता.
+
+- **मी हा कोर्स पुन्हा वापरू शकतो का?**
+नक्कीच! हा कोर्स परमिसिव्ह (permissive) [अपाचे २ लायसन्स (Apache 2 license)](https://www.apache.org/licenses/LICENSE-2.0.html) अंतर्गत प्रकाशित करण्यात आला आहे. याचा अर्थ असा की तुम्ही योग्य श्रेय (credit) दिले पाहिजे, लायसन्सची लिंक दिली पाहिजे आणि जर काही बदल केले असतील तर ते नमूद केले पाहिजेत. तुम्ही हे कोणत्याही वाजवी मार्गाने करू शकता, परंतु कोणत्याही प्रकारे परवाना देणाऱ्याने (licensor) तुम्हाला किंवा तुमच्या वापराला मान्यता दिली आहे असे सुचवता येणार नाही. जर तुम्हाला या कोर्सचा संदर्भ (cite) द्यायचा असेल, तर कृपया खालील BibTeX वापरा:
\ No newline at end of file
diff --git a/chapters/mr/chapter 1/10.mdx b/chapters/mr/chapter 1/10.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/11.mdx b/chapters/mr/chapter 1/11.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/2.mdx b/chapters/mr/chapter 1/2.mdx
new file mode 100644
index 000000000..1f856f6db
--- /dev/null
+++ b/chapters/mr/chapter 1/2.mdx
@@ -0,0 +1,52 @@
+# नॅचरल लँग्वेज प्रोसेसिंग आणि लार्ज लँग्वेज मॉडेल्स[[natural-language-processing-and-large-language-models]]
+
+
+
+ट्रान्सफॉर्मर (Transformer) मॉडेल्सकडे वळण्यापूर्वी, नॅचरल लँग्वेज प्रोसेसिंग म्हणजे काय, लार्ज लँग्वेज मॉडेल्सनी या क्षेत्रात कसा बदल घडवून आणला आहे आणि आपण त्याची काळजी का करतो, याचा थोडक्यात आढावा घेऊया.
+
+## NLP म्हणजे काय?[[what-is-nlp]]
+
+
+
+NLP हे भाषाशास्त्र (linguistics) आणि मशीन लर्निंगचे एक क्षेत्र आहे जे मानवी भाषेशी संबंधित सर्व काही समजून घेण्यावर केंद्रित आहे. NLP टास्कचा उद्देश केवळ एकेरी शब्दांचा स्वतंत्रपणे अर्थ समजून घेणे हा नसून, त्या शब्दांचा संदर्भ (context) समजून घेण्यास सक्षम असणे हा आहे.
+
+खाली काही सामान्य NLP टास्क्सची यादी त्यांच्या काही उदाहरणांसह दिली आहे:
+
+- **संपूर्ण वाक्यांचे वर्गीकरण करणे (Classifying whole sentences)**: रिव्ह्यूचे सेंटिमेंट (sentiment) मिळवणे, ईमेल स्पॅम आहे की नाही हे शोधणे, वाक्य व्याकरणदृष्ट्या योग्य आहे की नाही किंवा दोन वाक्ये तार्किकदृष्ट्या संबंधित आहेत की नाही हे ठरवणे.
+- **वाक्यातील प्रत्येक शब्दाचे वर्गीकरण करणे**: वाक्यातील व्याकरणाचे घटक (नाम, क्रियापद, विशेषण) किंवा नेम्ड एंटिटीज (व्यक्ती, ठिकाण, संस्था) ओळखणे.
+- **टेक्स्ट कंटेंट तयार करणे (Generating text content)**: ऑटोजेनरेटेड (auto-generated) टेक्स्टसह प्रॉम्प्ट पूर्ण करणे, टेक्स्ट मधील रिकाम्या जागा मास्क्ड (masked) शब्दांनी भरणे.
+- **टेक्स्ट मधून उत्तर काढणे**: दिलेला प्रश्न आणि संदर्भ (context) यावर आधारित, संदर्भात दिलेल्या माहितीवरून प्रश्नाचे उत्तर शोधून काढणे.
+- **इनपुट टेक्स्ट वरून नवीन वाक्य तयार करणे**: टेक्स्टचा दुसऱ्या भाषेत अनुवाद करणे, टेक्स्टचा सारांश (summarizing) काढणे.
+
+तथापि, NLP केवळ लिखित टेक्स्टपुरते मर्यादित नाही. ते स्पीच रेकग्निशन (speech recognition) आणि कॉम्प्युटर व्हिजनमधील (computer vision) जटिल आव्हानांना देखील सामोरे जाते, जसे की ऑडिओ सॅम्पलची ट्रान्सक्रिप्ट किंवा इमेजचे वर्णन तयार करणे.
+
+## लार्ज लँग्वेज मॉडेल्सचा (LLMs) उदय[[rise-of-llms]]
+
+अलिकडच्या वर्षांत, लार्ज लँग्वेज मॉडेल्सनी (LLMs) NLP क्षेत्रात क्रांती घडवून आणली आहे. GPT (जनरेटिव्ह प्री-ट्रेन्ड ट्रान्सफॉर्मर) आणि [Llama](https://huggingface.co/meta-llama) सारख्या आर्किटेक्चर्सचा समावेश असलेल्या या मॉडेल्सनी लँग्वेज प्रोसेसिंगमध्ये काय शक्य आहे हे पूर्णपणे बदलून टाकले आहे.
+
+> [!TIP]
+> लार्ज लँग्वेज मॉडेल (LLM) हे एक AI मॉडेल आहे जे मोठ्या प्रमाणातील टेक्स्ट डेटावर ट्रेन केलेले असते आणि ते मानवासारखे टेक्स्ट समजून घेऊ आणि तयार करू शकते, भाषेतील पॅटर्न ओळखू शकते आणि कोणत्याही विशिष्ट टास्कच्या ट्रेनिंगशिवाय अनेक प्रकारची भाषिक कार्ये करू शकते. ते नॅचरल लँग्वेज प्रोसेसिंग (NLP) क्षेत्रातील एक महत्त्वपूर्ण प्रगती दर्शवतात.
+
+LLMs ची वैशिष्ट्ये खालीलप्रमाणे आहेत:
+- **स्केल (Scale)**: त्यांच्यात लाखो, अब्जावधी किंवा शेकडो अब्जावधी पॅरामीटर्स (parameters) असतात.
+- **सामान्य क्षमता (General capabilities)**: ते टास्क-विशिष्ट (task-specific) ट्रेनिंगशिवाय अनेक कार्ये करू शकतात.
+- **इन-कॉन्टेक्स्ट लर्निंग (In-context learning)**: ते प्रॉम्प्टमध्ये दिलेल्या उदाहरणांवरून शिकू शकतात.
+- **इमर्जंट ॲबिलिटीज (Emergent abilities)**: जसजसा या मॉडेल्सचा आकार वाढतो, तसतसे ते अशा क्षमता दाखवतात ज्या स्पष्टपणे प्रोग्राम केलेल्या किंवा अपेक्षित नव्हत्या.
+
+LLMs च्या आगमनाने विशिष्ट NLP कार्यांसाठी विशेष मॉडेल्स तयार करण्याच्या पद्धतीकडून एकाच, मोठ्या मॉडेलचा वापर करण्याकडे एक स्थित्यंतर (paradigm shift) घडवून आणले आहे, ज्याला विविध भाषिक कार्यांसाठी प्रॉम्प्ट किंवा फाइन-ट्यून (fine-tune) केले जाऊ शकते. यामुळे प्रगत लँग्वेज प्रोसेसिंग अधिक सुलभ झाले आहे, पण सोबतच कार्यक्षमता, नैतिकता (ethics) आणि डिप्लॉयमेंट यांसारख्या क्षेत्रांमध्ये नवीन आव्हाने देखील उभी केली आहेत.
+
+तथापि, LLMs च्या काही महत्त्वाच्या मर्यादा देखील आहेत:
+- **हॅलुसिनेशन्स (Hallucinations)**: ते अत्यंत आत्मविश्वासाने चुकीची माहिती तयार करू शकतात.
+- **खऱ्या समजेचा अभाव**: त्यांच्याकडे जगाची खरी समज नसते आणि ते पूर्णपणे सांख्यिकीय पॅटर्नवर (statistical patterns) कार्य करतात.
+- **बायस (Bias / पूर्वग्रह)**: ते त्यांच्या ट्रेनिंग डेटामध्ये किंवा इनपुटमध्ये असलेले पूर्वग्रह पुन्हा निर्माण करू शकतात.
+- **कॉन्टेक्स्ट विंडोज (Context windows)**: त्यांच्याकडे मर्यादित कॉन्टेक्स्ट विंडोज असतात (जरी यामध्ये सुधारणा होत असली तरीही).
+- **कम्प्युटेशनल रिसोर्सेस (Computational resources)**: त्यांना मोठ्या प्रमाणावर संगणकीय संसाधनांची आवश्यकता असते.
+
+## लँग्वेज प्रोसेसिंग आव्हानात्मक का आहे?[[why-is-it-challenging]]
+
+संगणक माणसांप्रमाणे माहितीवर प्रक्रिया करत नाहीत. उदाहरणार्थ, जेव्हा आपण "मला भूक लागली आहे" हे वाक्य वाचतो, तेव्हा आपण त्याचा अर्थ सहज समजू शकतो. त्याचप्रमाणे, "मला भूक लागली आहे" आणि "मी दुःखी आहे" यासारखी दोन वाक्ये दिली असता, त्यांच्यात किती साम्य आहे हे आपण सहज ठरवू शकतो. मशीन लर्निंग (ML) मॉडेल्ससाठी अशी कार्ये अधिक कठीण असतात. टेक्स्टवर अशा प्रकारे प्रक्रिया करणे आवश्यक आहे ज्यामुळे मॉडेलला त्यातून शिकण्यास सक्षम करता येईल. आणि भाषा अत्यंत क्लिष्ट असल्यामुळे, ही प्रक्रिया कशी केली जावी याबद्दल आपल्याला काळजीपूर्वक विचार करणे आवश्यक आहे. टेक्स्टचे प्रतिनिधित्व (represent) कसे करावे यावर बरेच संशोधन झाले आहे, आणि आपण पुढील प्रकरणात काही पद्धती पाहणार आहोत.
+
+LLMs मधील प्रगतीनंतरही, अनेक मूलभूत आव्हाने अजूनही कायम आहेत. यामध्ये संदिग्धता (ambiguity), सांस्कृतिक संदर्भ, उपहास (sarcasm) आणि विनोद समजून घेणे यांचा समावेश आहे. विविध प्रकारच्या डेटासेटवर मोठ्या प्रमाणावर ट्रेनिंग देऊन LLMs या आव्हानांना सामोरे जातात, परंतु अनेक गुंतागुंतीच्या परिस्थितींमध्ये मानवी पातळीवरील समजूतदारपणाच्या तुलनेत ते अजूनही कमी पडतात.
diff --git a/chapters/mr/chapter 1/3.mdx b/chapters/mr/chapter 1/3.mdx
new file mode 100644
index 000000000..68492950a
--- /dev/null
+++ b/chapters/mr/chapter 1/3.mdx
@@ -0,0 +1,49 @@
+ट्रान्सफॉर्मर्स, ते काय करू शकतात?[[transformers-what-can-they-do]]
+
+या विभागात, आपण ट्रान्सफॉर्मर मॉडेल्स काय करू शकतात हे पाहू आणि 🤗 Transformers लायब्ररीतील आपले पहिले साधन वापरू: pipeline() फंक्शन.
+
+[!TIP] 👀 वर उजवीकडे Open in Colab बटण दिसतंय का? या विभागातील सर्व कोड उदाहरणांसह Google Colab नोटबुक उघडण्यासाठी त्यावर क्लिक करा. कोड उदाहरणे असलेल्या प्रत्येक विभागात हे बटण दिसेल.
+
+जर तुम्हाला उदाहरणे स्थानिक पातळीवर (locally) चालवायची असतील, तर सेटअप पाहण्याची शिफारस करतो.
+
+ट्रान्सफॉर्मर्स सर्वत्र आहेत![[transformers-are-everywhere]]
+
+नैसर्गिक भाषा प्रक्रिया (NLP), संगणकीय दृष्टी (computer vision), ऑडिओ प्रक्रिया आणि इतर विविध क्षेत्रांतील सर्व प्रकारची कामे सोडवण्यासाठी ट्रान्सफॉर्मर मॉडेल्स वापरली जातात. Hugging Face आणि ट्रान्सफॉर्मर मॉडेल्स वापरणाऱ्या आणि समुदायाला परत योगदान देणाऱ्या (त्यांची मॉडेल्स शेअर करून) काही कंपन्या आणि संस्था इथे दाखवल्या आहेत:
+
+
+
+🤗 Transformers लायब्ररी ही शेअर केलेली मॉडेल्स तयार करण्याची आणि वापरण्याची क्षमता पुरवते. Model Hub मध्ये लाखो प्रशिक्षित (pretrained) मॉडेल्स आहेत, जी कोणीही डाउनलोड करून वापरू शकतं. तुम्ही तुमची स्वतःची मॉडेल्ससुद्धा Hub वर अपलोड करू शकता!
+
+[!TIP] ⚠️ Hugging Face Hub फक्त ट्रान्सफॉर्मर मॉडेल्सपुरतं मर्यादित नाही. कोणीही कोणत्याही प्रकारची मॉडेल्स किंवा डेटासेट्स शेअर करू शकतो! सर्व उपलब्ध वैशिष्ट्यांचा लाभ घेण्यासाठी huggingface.co खातं तयार करा!
+
+ट्रान्सफॉर्मर मॉडेल्स आतून कशी काम करतात हे पाहण्याआधी, काही मनोरंजक NLP समस्या सोडवण्यासाठी ती कशी वापरली जाऊ शकतात याची काही उदाहरणं पाहूया.
+
+पाइपलाइन्ससोबत काम करणे[[working-with-pipelines]]
+
+🤗 Transformers लायब्ररीतील सर्वात मूलभूत ऑब्जेक्ट म्हणजे pipeline() फंक्शन. हे मॉडेलला त्याच्या आवश्यक प्री-प्रोसेसिंग आणि पोस्ट-प्रोसेसिंग पायऱ्यांशी जोडतं, ज्यामुळे आपण थेट कोणताही मजकूर इनपुट करून समजण्याजोगं उत्तर मिळवू शकतो:
+
+python
+from transformers import pipeline
+
+classifier = pipeline("sentiment-analysis")
+classifier("I've been waiting for a HuggingFace course my whole life.")
+python
+[{'label': 'POSITIVE', 'score': 0.9598047137260437}]
+
+आपण अनेक वाक्येसुद्धा एकत्र पाठवू शकतो!
+
+python
+classifier(
+ ["I've been waiting for a HuggingFace course my whole life.", "I hate this so much!"]
+)
+python
+[{'label': 'POSITIVE', 'score': 0.9598047137260437},
+ {'label': 'NEGATIVE', 'score': 0.9994558095932007}]
+
+डिफॉल्टनुसार, ही पाइपलाइन इंग्रजीतील भावना विश्लेषणासाठी (sentiment analysis) फाइन-ट्यून केलेलं एक विशिष्ट पूर्व-प्रशिक्षित मॉडेल निवडते. जेव्हा तुम्ही classifier ऑब्जेक्ट तयार करता, तेव्हा मॉडेल डाउनलोड होऊन कॅश (cache) होतं. जर तुम्ही कमांड पुन्हा चालवली, तर कॅश केलेलं मॉडेल वापरलं जाईल आणि पुन्हा डाउनलोड करण्याची गरज पडणार नाही.
+
+जेव्हा तुम्ही पाइपलाइनला काही मजकूर पाठवता, तेव्हा तीन मुख्य पायऱ्या घडतात:
+
+मजकूर मॉडेलला समजेल अशा स्वरूपात प्री-प्रोसेस केला जातो.
+प्री-प्रोसेस केलेले इनपुट मॉडेलकडे पाठवले जातात.
+मॉडेलचे अंदाज (predictions) पोस्ट-प्रोसेस केले जातात, जेणेकरून तुम्हाला त्यांचा अर्थ समजू शकेल.
\ No newline at end of file
diff --git a/chapters/mr/chapter 1/4.mdx b/chapters/mr/chapter 1/4.mdx
new file mode 100644
index 000000000..a89ab03df
--- /dev/null
+++ b/chapters/mr/chapter 1/4.mdx
@@ -0,0 +1,133 @@
+ट्रान्सफॉर्मर्स कसे काम करतात?[[how-do-transformers-work]]
+या विभागात, आपण ट्रान्सफॉर्मर मॉडेल्सच्या आर्किटेक्चर (रचनेवर) एक नजर टाकू आणि अटेन्शन, एन्कोडर-डिकोडर आर्किटेक्चर आणि इतर संकल्पना अधिक सखोलपणे समजून घेऊ.
+
+[!WARNING]
+🚀 आपण येथे एक पाऊल पुढे टाकत आहोत. हा विभाग तपशीलवार आणि तांत्रिक आहे, त्यामुळे तुम्हाला सर्व काही लगेच समजले नाही तरी काळजी करू नका. आपण या कोर्समध्ये नंतर या संकल्पनांवर पुन्हा सविस्तर चर्चा करू.
+
+ट्रान्सफॉर्मरचा थोडा इतिहास[[a-bit-of-transformer-history]]
+ट्रान्सफॉर्मर मॉडेल्सच्या (लहान) इतिहासातील काही महत्त्वाचे टप्पे (reference points) येथे दिले आहेत:
+
+ट्रान्सफॉर्मर आर्किटेक्चर जून २०१७ मध्ये सादर केले गेले. मूळ संशोधनाचा मुख्य भर भाषांतर (translation) कार्यांवर होता. यानंतर अनेक प्रभावशाली मॉडेल्स सादर केली गेली, ज्यामध्ये खालील मॉडेल्सचा समावेश आहे:
+
+जून २०१८: GPT, पहिले प्री-ट्रेंड ट्रान्सफॉर्मर मॉडेल, जे विविध NLP (नॅचरल लँग्वेज प्रोसेसिंग) कार्यांवर फाइन-ट्युनिंगसाठी वापरले गेले आणि ज्याने उत्कृष्ट (state-of-the-art) परिणाम मिळवले.
+
+ऑक्टोबर २०१८: BERT, दुसरे मोठे प्री-ट्रेंड मॉडेल, जे वाक्यांचे अधिक चांगले सारांश तयार करण्यासाठी डिझाइन केले गेले (पुढील प्रकरणात याबद्दल अधिक माहिती!).
+
+फेब्रुवारी २०१९: GPT-2, GPT ची सुधारित (आणि मोठी) आवृत्ती जी नैतिक चिंतांमुळे (ethical concerns) त्वरित सार्वजनिकपणे प्रदर्शित केली गेली नाही.
+
+ऑक्टोबर २०१९: T5, सिक्वेन्स-टू-सिक्वेन्स ट्रान्सफॉर्मर आर्किटेक्चरचे मल्टी-टास्क केंद्रित अंमलबजावणी मॉडेल.
+
+मे २०२०: GPT-3, GPT-2 ची आणखी मोठी आवृत्ती जी फाइन-ट्युनिंगच्या गरजेशिवाय विविध कामे उत्तम प्रकारे करू शकते (याला झिरो-शॉट लर्निंग म्हणतात).
+
+जानेवारी २०२२: InstructGPT, GPT-3 ची एक आवृत्ती ज्याला सूचनांचे (instructions) अधिक चांगल्या प्रकारे पालन करण्यासाठी प्रशिक्षित केले गेले.
+
+जानेवारी २०२३: Llama, एक लार्ज लँग्वेज मॉडेल (LLM) जे विविध भाषांमध्ये मजकूर तयार करू शकते.
+
+मार्च २०२३: Mistral, ७-अब्ज-पॅरामीटर्सचे लँग्वेज मॉडेल जे Llama 2 13B ला सर्व मूल्यमापन केलेल्या बेंचमार्कवर मागे टाकते. हे जलद इन्फरन्ससाठी ग्रुप्ड-क्वेरी अटेन्शन (grouped-query attention) आणि कोणत्याही लांबीच्या सिक्वेन्स हाताळण्यासाठी स्लाइडिंग विंडो अटेन्शन (sliding window attention) चा वापर करते.
+
+मे २०२४: Gemma 2, २ अब्ज (2B) ते २७ अब्ज (27B) पॅरामीटर्सपर्यंतच्या हलक्या (lightweight), अत्याधुनिक ओपन मॉडेल्सचा समूह, ज्यामध्ये इंटरलीव्ह्ड लोकल-ग्लोबल अटेन्शन आणि ग्रुप-क्वेरी अटेन्शन समाविष्ट आहे. यातील लहान मॉडेल्स नॉलेज डिस्टिलेशन (knowledge distillation) वापरून प्रशिक्षित केली गेली आहेत, जी त्यांच्यापेक्षा २-३ पट मोठ्या मॉडेल्सच्या तुलनेत उत्कृष्ट कामगिरी देतात.
+
+नोव्हेंबर २०२४: SmolLM2, एक अत्याधुनिक लहान लँग्वेज मॉडेल (१३५ दशलक्ष ते १.७ अब्ज पॅरामीटर्स) जे त्याच्या लहान आकारमान असूनही प्रभावी कामगिरी साध्य करते आणि मोबाइल आणि एज (edge) उपकरणांसाठी नवीन शक्यता उघडते.
+
+ही यादी पूर्णपणे सर्वसमावेशक नाही, आणि ती फक्त काही वेगवेगळ्या प्रकारच्या ट्रान्सफॉर्मर मॉडेल्सवर प्रकाश टाकण्यासाठी आहे. सामान्यतः, त्यांना तीन श्रेणींमध्ये विभागले जाऊ शकते:
+
+GPT-सारखे (ज्यांना ऑटो-रिग्रेसिव्ह ट्रान्सफॉर्मर मॉडेल्स असेही म्हणतात)
+
+BERT-सारखे (ज्यांना ऑटो-एन्कोडिंग ट्रान्सफॉर्मर मॉडेल्स असेही म्हणतात)
+
+T5-सारखे (ज्यांना सिक्वेन्स-टू-सिक्वेन्स ट्रान्सफॉर्मर मॉडेल्स असेही म्हणतात)
+
+आपण पुढे या श्रेणींबद्दल (families) अधिक सविस्तर जाणून घेऊ.
+
+ट्रान्सफॉर्मर्स हे लँग्वेज मॉडेल्स आहेत[[transformers-are-language-models]]
+वर नमूद केलेली सर्व ट्रान्सफॉर्मर मॉडेल्स (GPT, BERT, T5 इ.) लँग्वेज मॉडेल्स (भाषा मॉडेल्स) म्हणून प्रशिक्षित केली गेली आहेत. याचा अर्थ त्यांना सेल्फ-सुपरवाइज्ड (self-supervised) पद्धतीने मोठ्या प्रमाणातील कच्च्या (raw) मजकुरावर प्रशिक्षित केले गेले आहे.
+
+सेल्फ-सुपरवाइज्ड लर्निंग (Self-supervised learning) हा प्रशिक्षणाचा एक प्रकार आहे ज्यामध्ये मॉडेलच्या इनपुटमधून उद्दिष्ट (objective) स्वयंचलितपणे मोजले जाते. याचा अर्थ असा की डेटाला लेबल करण्यासाठी मानवांची आवश्यकता नाही!
+
+अशा प्रकारचे मॉडेल ज्या भाषेवर प्रशिक्षित केले जाते, तिची सांख्यिकीय (statistical) समज विकसित करते, परंतु ते विशिष्ट व्यावहारिक कार्यांसाठी कमी उपयुक्त असते. यामुळे, सामान्य प्री-ट्रेंड मॉडेल त्यानंतर ट्रान्सफर लर्निंग (transfer learning) किंवा फाइन-ट्युनिंग (fine-tuning) नावाच्या प्रक्रियेतून जाते. या प्रक्रियेदरम्यान, मॉडेलला एखाद्या विशिष्ट कार्यासाठी सुपरवाइज्ड पद्धतीने -- म्हणजेच, मानवी-चिन्हांकित लेबल्स वापरून -- फाइन-ट्यून केले जाते.
+
+एखाद्या कार्याचे उदाहरण म्हणजे n मागील शब्द वाचून वाक्यातील पुढील शब्दाचा अंदाज लावणे (predict करणे). याला कॉझल लँग्वेज मॉडेलिंग (causal language modeling) म्हणतात कारण आउटपुट भूतकाळातील आणि वर्तमान इनपुट्सवर अवलंबून असते, परंतु भविष्यातील इनपुट्सवर नाही.
+
+दुसरे उदाहरण म्हणजे मास्क्ड लँग्वेज मॉडेलिंग (masked language modeling), ज्यामध्ये मॉडेल वाक्यातील लपवलेल्या (masked) शब्दाचा अंदाज लावते.
+
+ट्रान्सफॉर्मर्स हे मोठे मॉडेल्स आहेत[[transformers-are-big-models]]
+(DistilBERT सारखे) काही अपवाद वगळता, चांगली कामगिरी मिळवण्यासाठी सामान्य धोरण म्हणजे मॉडेल्सचा आकार वाढवणे तसेच त्यांना ज्या डेटावर प्री-ट्रेन केले जाते त्याचे प्रमाण वाढवणे.
+
+दुर्दैवाने, मॉडेलला प्रशिक्षित करण्यासाठी, विशेषतः मोठ्या मॉडेलला, मोठ्या प्रमाणावर डेटा लागतो. हे वेळ आणि संगणकीय संसाधनांच्या (compute resources) बाबतीत खूप खर्चिक बनते. खालील आलेखात पाहिल्याप्रमाणे, याचा पर्यावरणावर देखील परिणाम होतो.
+
+आणि हे एका (खूप मोठ्या) मॉडेलच्या प्रकल्पासाठी दर्शविले आहे ज्याचे नेतृत्व अशा टीमने केले आहे जे प्री-ट्रेनिंगचा पर्यावरणीय प्रभाव जाणीवपूर्वक कमी करण्याचा प्रयत्न करत आहेत. सर्वोत्तम हायपरपॅरामीटर्स मिळवण्यासाठी अनेक चाचण्या घेण्याचा पर्यावरणीय प्रभाव (carbon footprint) याहूनही जास्त असेल.
+
+कल्पना करा की प्रत्येक वेळी एखादी संशोधन संस्था, विद्यार्थी संघटना किंवा कंपनीला मॉडेल प्रशिक्षित करायचे असेल, आणि त्यांनी ते शून्यापासून (from scratch) सुरू केले तर काय होईल. यामुळे मोठ्या प्रमाणावर अनावश्यक जागतिक खर्च वाढेल!
+
+म्हणूनच लँग्वेज मॉडेल्स शेअर करणे अत्यंत महत्त्वाचे आहे: प्रशिक्षित वेट्स (trained weights) सामायिक करणे आणि आधीच प्रशिक्षित असलेल्या वेट्सच्या आधारे पुढील काम करणे यामुळे समुदायाचा एकूण संगणकीय खर्च आणि कार्बन फूटप्रिंट कमी होतो.
+
+तसे पाहता, तुम्ही तुमच्या मॉडेल्सच्या प्रशिक्षणाचा कार्बन फूटप्रिंट अनेक साधनांद्वारे मोजू शकता. उदाहरणार्थ, ML CO2 Impact किंवा Code Carbon जे 🤗 Transformers मध्ये समाकलित (integrated) केले आहे. याबद्दल अधिक जाणून घेण्यासाठी, तुम्ही ही ब्लॉग पोस्ट वाचू शकता जी तुम्हाला तुमच्या प्रशिक्षणाच्या फूटप्रिंटचा अंदाज असलेल्या emissions.csv फाइल कशी तयार करायची ते दर्शवेल, तसेच 🤗 Transformers चे डॉक्युमेंटेशन जे या विषयावर मार्गदर्शन करते.
+
+ट्रान्सफर लर्निंग (Transfer Learning)[[transfer-learning]]
+प्री-ट्रेनिंग (Pretraining) म्हणजे एखाद्या मॉडेलला शून्यापासून (from scratch) प्रशिक्षित करण्याची प्रक्रिया: यामध्ये वेट्स (weights) यादृच्छिकपणे (randomly) सुरू केले जातात आणि कोणत्याही पूर्वज्ञानाशिवाय प्रशिक्षण सुरू होते.
+
+हे प्री-ट्रेनिंग सहसा अत्यंत मोठ्या प्रमाणातील डेटावर केले जाते. त्यामुळे, यासाठी डेटाचा खूप मोठा संग्रह (corpus) लागतो, आणि प्रशिक्षणासाठी कित्येक आठवडे लागू शकतात.
+
+दुसरीकडे, फाइन-ट्युनिंग (Fine-tuning) हे मॉडेलला प्री-ट्रेन केल्यानंतर केले जाणारे प्रशिक्षण आहे. फाइन-ट्युनिंग करण्यासाठी, तुम्ही आधी एक प्री-ट्रेंड लँग्वेज मॉडेल मिळवता, आणि नंतर तुमच्या विशिष्ट कार्यासाठी तयार केलेल्या डेटासेटसह अतिरिक्त प्रशिक्षण देता. थांबा -- तुमच्या अंतिम उपयोगासाठी (use case) मॉडेलला सुरुवातीपासूनच (शून्यापासून/scratch) का प्रशिक्षित करू नये? याची काही कारणे आहेत:
+
+प्री-ट्रेंड मॉडेल आधीच अशा डेटासेटवर प्रशिक्षित केलेले असते ज्याचे फाइन-ट्युनिंग डेटासेटशी काही साधर्म्य असते. त्यामुळे फाइन-ट्युनिंग प्रक्रिया प्रारंभिक मॉडेलने प्री-ट्रेनिंग दरम्यान मिळवलेल्या ज्ञानाचा फायदा घेऊ शकते (उदाहरणार्थ, NLP समस्यांमध्ये, प्री-ट्रेंड मॉडेलला तुम्ही तुमच्या कामासाठी वापरत असलेल्या भाषेची काही प्रमाणात सांख्यिकीय समज असेल).
+
+प्री-ट्रेंड मॉडेल आधीच भरपूर डेटावर प्रशिक्षित झालेले असल्याने, चांगले परिणाम मिळवण्यासाठी फाइन-ट्युनिंगला खूप कमी डेटा लागतो.
+
+याच कारणामुळे, चांगले परिणाम मिळवण्यासाठी लागणारा वेळ आणि संसाधने खूप कमी असतात.
+
+उदाहरणार्थ, इंग्रजी भाषेवर प्रशिक्षित केलेले एखादे प्री-ट्रेंड मॉडेल वापरून नंतर ते arXiv कॉर्पसवर (विज्ञान संशोधनातील पेपर्स) फाइन-ट्यून केले जाऊ शकते, ज्यामुळे विज्ञान/संशोधन-आधारित मॉडेल तयार होईल. या फाइन-ट्युनिंगला फक्त मर्यादित प्रमाणात डेटा लागेल: प्री-ट्रेंड मॉडेलने जे ज्ञान आधीच मिळवले आहे ते "हस्तांतरित" (transferred) केले जाते, म्हणूनच याला ट्रान्सफर लर्निंग (transfer learning) असे म्हणतात.
+
+मॉडेल फाइन-ट्यून करण्यामुळे वेळ, डेटा, आर्थिक खर्च आणि पर्यावरणीय प्रभाव कमी असतो. वेगवेगळ्या फाइन-ट्युनिंग योजनांवर काम करणे देखील अधिक जलद आणि सोपे असते, कारण हे प्रशिक्षण पूर्ण प्री-ट्रेनिंगपेक्षा कमी वेळखाऊ असते.
+
+या प्रक्रियेमुळे शून्यापासून प्रशिक्षण देण्याच्या तुलनेत (तुमच्याकडे भरपूर डेटा असल्याशिवाय) चांगले परिणाम मिळतील. म्हणूनच तुम्ही नेहमी एखाद्या प्री-ट्रेंड मॉडेलचा फायदा घेण्याचा प्रयत्न केला पाहिजे -- जे मॉडेल तुमच्या कामाशी शक्य तितके जवळचे असेल -- आणि त्याला फाइन-ट्यून केले पाहिजे.
+
+सामान्य ट्रान्सफॉर्मर आर्किटेक्चर[[general-transformer-architecture]]
+या विभागात, आपण ट्रान्सफॉर्मर मॉडेलच्या सामान्य आर्किटेक्चरवर (रचनेवर) चर्चा करू. तुम्हाला काही संकल्पना समजल्या नाहीत तर काळजी करू नका; पुढील भागांमध्ये प्रत्येक घटकावर सविस्तर चर्चा केली आहे.
+
+हे मॉडेल प्रामुख्याने दोन ब्लॉक्सचे बनलेले असते:
+
+एन्कोडर (डावीकडे): एन्कोडरला इनपुट मिळते आणि तो त्याचे प्रतिनिधित्व (representation) म्हणजेच वैशिष्ट्ये (features) तयार करतो. याचा अर्थ असा की हे मॉडेल इनपुटमधून समज मिळवण्यासाठी अनुकूल (optimized) केलेले असते.
+
+डिकोडर (उजवीकडे): डिकोडर टार्गेट सिक्वेन्स (लक्ष्य क्रम) तयार करण्यासाठी एन्कोडरचे प्रतिनिधित्व (वैशिष्ट्ये) आणि इतर इनपुट्स वापरतो. याचा अर्थ असा की हे मॉडेल आउटपुट जनरेट करण्यासाठी अनुकूल केलेले असते.
+
+कामाच्या स्वरूपानुसार हे दोन्ही भाग स्वतंत्रपणे वापरले जाऊ शकतात:
+
+फक्त-एन्कोडर मॉडेल्स (Encoder-only models): वाक्यांचे वर्गीकरण (sentence classification) आणि नेम्ड एंटिटी रेकग्निशन (named entity recognition) यासारख्या इनपुट समजून घेण्याची आवश्यकता असलेल्या कार्यांसाठी चांगले.
+
+फक्त-डिकोडर मॉडेल्स (Decoder-only models): मजकूर निर्मितीसारख्या (text generation) जनरेटिव्ह (generative) कार्यांसाठी चांगले.
+
+एन्कोडर-डिकोडर मॉडेल्स किंवा सिक्वेन्स-टू-सिक्वेन्स मॉडेल्स: भाषांतर (translation) किंवा सारांश (summarization) यासारख्या इनपुटची आवश्यकता असलेल्या जनरेटिव्ह कार्यांसाठी चांगले.
+
+आपण पुढील विभागांमध्ये या आर्किटेक्चर्सबद्दल स्वतंत्रपणे सविस्तर माहिती घेऊ.
+
+अटेन्शन लेयर्स (Attention layers)[[attention-layers]]
+ट्रान्सफॉर्मर मॉडेल्सचे एक प्रमुख वैशिष्ट्य म्हणजे ते अटेन्शन लेयर्स (attention layers) नावाच्या विशेष स्तरांनी बनलेले असतात. किंबहुना, ट्रान्सफॉर्मर आर्किटेक्चर सादर करणाऱ्या पेपरचे शीर्षकच "Attention Is All You Need" असे होते! आपण कोर्समध्ये नंतर अटेन्शन लेयर्सचे तपशील पाहू; सध्या तुम्हाला फक्त एवढेच माहित असणे आवश्यक आहे की हा लेयर मॉडेलला प्रत्येक शब्दाच्या प्रतिनिधित्वावर (representation) काम करताना, तुम्ही दिलेल्या वाक्यातील विशिष्ट शब्दांवर विशेष लक्ष देण्यास (आणि बाकीच्यांकडे कमी लक्ष देण्यास किंवा दुर्लक्ष करण्यास) सांगतो.
+
+हे संदर्भासह समजून घेण्यासाठी, इंग्रजीतून फ्रेंचमध्ये मजकूर भाषांतरित करण्याचे कार्य विचारात घ्या. "You like this course" हे इनपुट दिल्यास, ट्रान्सलेशन मॉडेलला "like" शब्दाचे योग्य भाषांतर करण्यासाठी त्याच्या लगतच्या "You" या शब्दाकडे देखील लक्ष (attend) द्यावे लागेल, कारण फ्रेंचमध्ये "like" हे क्रियापद कर्त्यानुसार (subject) वेगळ्या प्रकारे चालवले जाते. मात्र, वाक्याचा उरलेला भाग त्या शब्दाच्या भाषांतरासाठी उपयोगी नाही. त्याचप्रमाणे, "this" चे भाषांतर करताना मॉडेलला "course" या शब्दाकडे देखील लक्ष द्यावे लागेल, कारण "this" चे भाषांतर निगडीत नाम (noun) पुल्लिंगी आहे की स्त्रीलिंगी यावर अवलंबून बदलते. पुन्हा, वाक्यातील इतर शब्दांचा "course" च्या भाषांतरासाठी काहीही फरक पडणार नाही. अधिक गुंतागुंतीच्या वाक्यांसह (आणि अधिक गुंतागुंतीच्या व्याकरणाच्या नियमांसह), मॉडेलला प्रत्येक शब्दाचे योग्य भाषांतर करण्यासाठी वाक्यात दूरवर असलेल्या शब्दांवर विशेष लक्ष द्यावे लागेल.
+
+हीच संकल्पना नैसर्गिक भाषेशी (natural language) संबंधित कोणत्याही कार्याला लागू होते: शब्दाचा स्वतःचा एक अर्थ असतो, परंतु तो अर्थ संदर्भाने (context) खूप प्रभावित होतो, जो अभ्यासल्या जात असलेल्या शब्दाच्या आधीचा किंवा नंतरचा कोणताही अन्य शब्द (किंवा शब्द) असू शकतो.
+
+आता तुम्हाला अटेन्शन लेयर्स म्हणजे काय याची कल्पना आली आहे, तर आपण ट्रान्सफॉर्मर आर्किटेक्चर अधिक जवळून पाहूया.
+
+मूळ आर्किटेक्चर (The original architecture)[[the-original-architecture]]
+ट्रान्सफॉर्मर आर्किटेक्चर मूळतः भाषांतरासाठी डिझाइन केले गेले होते. प्रशिक्षणादरम्यान, एन्कोडरला एका विशिष्ट भाषेत इनपुट (वाक्ये) मिळतात, तर डिकोडरला तीच वाक्ये अपेक्षित लक्ष्य भाषेत (target language) मिळतात. एन्कोडरमध्ये, अटेन्शन लेयर्स वाक्यातील सर्व शब्द वापरू शकतात (कारण, आपण आत्ताच पाहिल्याप्रमाणे, एखाद्या शब्दाचे भाषांतर त्याच्या आधी तसेच नंतर काय आहे यावर अवलंबून असू शकते). मात्र, डिकोडर अनुक्रमे (sequentially) कार्य करतो आणि त्याने आधीच भाषांतरित केलेल्या वाक्यातील शब्दांवरच लक्ष देऊ शकतो (म्हणजेच, सध्या जनरेट होत असलेल्या शब्दाच्या आधीच्या शब्दांवरच). उदाहरणार्थ, जेव्हा आपण अनुवादित लक्ष्याचे पहिले तीन शब्द शोधतो (predict करतो), तेव्हा आपण ते डिकोडरला देतो जो नंतर चौथा शब्द शोधण्याचा प्रयत्न करण्यासाठी एन्कोडरचे सर्व इनपुट्स वापरतो.
+
+प्रशिक्षणादरम्यान वेगाने काम करण्यासाठी (जेव्हा मॉडेलला टार्गेट वाक्यांचा अॅक्सेस असतो), डिकोडरला संपूर्ण टार्गेट दिले जाते, परंतु त्याला भविष्यातील शब्द वापरण्याची परवानगी नसते (जर त्याला २ रा शब्द शोधताना २ ऱ्या स्थानावरील शब्दाचा अॅक्सेस मिळाला, तर ही समस्या फार अवघड राहणार नाही!). उदाहरणार्थ, चौथा शब्द शोधण्याचा प्रयत्न करताना, अटेन्शन लेयरला फक्त १ ते ३ स्थानांवरील शब्दांचाच अॅक्सेस असेल.
+
+मूळ ट्रान्सफॉर्मर आर्किटेक्चर डावीकडे एन्कोडर आणि उजवीकडे डिकोडरसह असे दिसत होते:
+
+लक्षात घ्या की डिकोडर ब्लॉकमधील पहिला अटेन्शन लेयर डिकोडरच्या सर्व (मागील) इनपुट्सकडे लक्ष देतो, परंतु दुसरा अटेन्शन लेयर एन्कोडरचे आउटपुट वापरतो. त्यामुळे तो सध्याचा शब्द उत्तम प्रकारे शोधण्यासाठी (predict करण्यासाठी) संपूर्ण इनपुट वाक्याचा अॅक्सेस मिळवू शकतो. हे खूप उपयुक्त आहे कारण वेगवेगळ्या भाषांमध्ये व्याकरणाचे नियम असू शकतात जे शब्दांना वेगवेगळ्या क्रमाने ठेवतात किंवा वाक्यात नंतर दिलेला काही संदर्भ एखाद्या शब्दाचे सर्वोत्तम भाषांतर ठरवण्यासाठी उपयुक्त ठरू शकतो.
+
+एन्कोडर/डिकोडरमध्ये मॉडेलला काही विशेष शब्दांकडे लक्ष देण्यापासून रोखण्यासाठी अटेन्शन मास्क (attention mask) देखील वापरला जाऊ शकतो -- उदाहरणार्थ, वाक्ये एकत्र बॅच (batch) करताना सर्व इनपुट्स समान लांबीचे करण्यासाठी वापरलेला विशेष पॅडिंग (padding) शब्द.
+
+आर्किटेक्चर्स वि. चेकपॉइंट्स (Architectures vs. checkpoints)[[architecture-vs-checkpoints]]
+जसजसे आपण या कोर्समध्ये ट्रान्सफॉर्मर मॉडेल्सबद्दल खोलवर जाणून घेऊ, तसतसे तुम्हाला आर्किटेक्चर्स (architectures) आणि चेकपॉइंट्स (checkpoints) तसेच मॉडेल्स चे संदर्भ दिसतील. या सर्व संज्ञांचे अर्थ थोडे वेगळे आहेत:
+
+आर्किटेक्चर (Architecture): हा मॉडेलचा सांगाडा (skeleton) आहे -- प्रत्येक लेयरची व्याख्या आणि मॉडेलमध्ये होणारी प्रत्येक क्रिया (operation).
+
+चेकपॉइंट्स (Checkpoints): हे असे वेट्स (weights) आहेत जे दिलेल्या आर्किटेक्चरमध्ये लोड केले जातील.
+
+मॉडेल (Model): ही एक सर्वसमावेशक (umbrella) संज्ञा आहे जी "आर्किटेक्चर" किंवा "चेकपॉइंट" इतकी अचूक नाही: याचा अर्थ दोन्ही असू शकतो. संदिग्धता कमी करण्यासाठी जेव्हा महत्त्वाचे असेल तेव्हा हा कोर्स आर्किटेक्चर किंवा चेकपॉइंट नमूद करेल.
+
+उदाहरणार्थ, BERT हे एक आर्किटेक्चर आहे तर bert-base-cased (जे BERT च्या पहिल्या रिलीझसाठी गुगल टीमने प्रशिक्षित केलेल्या वेट्सचा संच आहे) हा एक चेकपॉइंट आहे. तथापि, कोणीही "BERT मॉडेल" आणि "bert-base-cased मॉडेल" असे म्हणू शकतो.
\ No newline at end of file
diff --git a/chapters/mr/chapter 1/5.mdx b/chapters/mr/chapter 1/5.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/6.mdx b/chapters/mr/chapter 1/6.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/7.mdx b/chapters/mr/chapter 1/7.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/8.mdx b/chapters/mr/chapter 1/8.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/9.mdx b/chapters/mr/chapter 1/9.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 2/1.mdx b/chapters/mr/chapter 2/1.mdx
new file mode 100644
index 000000000..d28cd3766
--- /dev/null
+++ b/chapters/mr/chapter 2/1.mdx
@@ -0,0 +1,20 @@
+परिचय[[परिचय]]
+
+
+
+तुम्ही प्रकरण 1 मध्ये पाहिल्याप्रमाणे, ट्रान्सफॉर्मर मॉडेल्स सहसा खूप मोठे असतात. लाखो ते हजारो कोटी पॅरामीटर्ससह, या मॉडेल्सना प्रशिक्षण देणे आणि तैनात करणे ही एक गुंतागुंतीची प्रक्रिया आहे. शिवाय, जवळजवळ दररोज नवीन मॉडेल्स प्रकाशित होत असल्याने आणि प्रत्येकाची स्वतःची अंमलबजावणी असल्याने, ती सर्व वापरून पाहणे सोपे काम नाही.
+
+ही समस्या सोडवण्यासाठी 🤗 ट्रान्सफॉर्मर्स लायब्ररी तयार करण्यात आली. कोणतेही ट्रान्सफॉर्मर मॉडेल लोड करण्यासाठी, प्रशिक्षण देण्यासाठी आणि जतन करण्यासाठी एकच API प्रदान करणे हे तिचे उद्दिष्ट आहे. लायब्ररीची मुख्य वैशिष्ट्ये अशी आहेत:
+
+वापरण्यास सुलभता: निष्कर्षासाठी (inference) अत्याधुनिक NLP मॉडेल डाउनलोड करणे, लोड करणे आणि वापरणे फक्त दोन ओळींच्या कोडमध्ये करता येते.
+लवचिकता: त्यांच्या गाभ्यात, सर्व मॉडेल्स साधे PyTorch nn.Module वर्ग आहेत आणि त्यांच्या संबंधित मशीन लर्निंग (ML) फ्रेमवर्क्समधील इतर कोणत्याही मॉडेल्सप्रमाणे हाताळता येतात.
+साधेपणा: संपूर्ण लायब्ररीमध्ये फारसे अॅबस्ट्रॅक्शन्स केलेले नाहीत. "ऑल इन वन फाइल" ही एक मुख्य संकल्पना आहे: मॉडेलचा फॉरवर्ड पास संपूर्णपणे एकाच फाइलमध्ये परिभाषित केलेला असतो, त्यामुळे कोड स्वतःच समजण्याजोगा आणि हॅक करण्यायोग्य असतो.
+
+हे शेवटचे वैशिष्ट्य 🤗 ट्रान्सफॉर्मर्सला इतर ML लायब्ररींपेक्षा बरेच वेगळे बनवते. मॉडेल्स फाइल्समध्ये सामायिक केलेल्या मॉड्यूल्सवर तयार केलेले नाहीत; त्याऐवजी, प्रत्येक मॉडेलचे स्वतःचे स्तर (layers) असतात. मॉडेल्स अधिक सुगम आणि समजण्याजोगे बनवण्याबरोबरच, यामुळे तुम्हाला इतर मॉडेल्सवर परिणाम न करता एका मॉडेलवर सहजपणे प्रयोग करता येतो.
+
+हे प्रकरण एका एंड-टू-एंड उदाहरणाने सुरू होईल, ज्यामध्ये आपण प्रकरण 1 मध्ये सादर केलेल्या pipeline() फंक्शनची पुनरावृत्ती करण्यासाठी मॉडेल आणि टोकनायझर एकत्र वापरू. पुढे, आपण मॉडेल API बद्दल चर्चा करू: आपण मॉडेल आणि कॉन्फिगरेशन वर्गांमध्ये सखोलपणे जाऊ, आणि मॉडेल कसे लोड करावे आणि ते संख्यात्मक इनपुट्सना आउटपुट भाकितांमध्ये कसे प्रक्रिया करते हे तुम्हाला दाखवू.
+
+त्यानंतर आपण टोकनायझर API कडे पाहू, जो pipeline() फंक्शनचा दुसरा मुख्य घटक आहे. टोकनायझर्स पहिल्या आणि शेवटच्या प्रक्रिया पायऱ्या हाताळतात, मजकुरापासून न्यूरल नेटवर्कसाठी संख्यात्मक इनपुट्समध्ये रूपांतर करतात, आणि आवश्यक असेल तेव्हा पुन्हा मजकुरात रूपांतर करतात. शेवटी, तयार केलेल्या बॅचमध्ये अनेक वाक्ये मॉडेलमधून कशी पाठवायची हे आपण तुम्हाला दाखवू, आणि नंतर उच्च-स्तरीय tokenizer() फंक्शनवर सखोल नजर टाकून सर्व काही पूर्ण करू.
+
+[!TIP]
+⚠️ मॉडेल हब आणि 🤗 ट्रान्सफॉर्मर्ससोबत उपलब्ध असलेल्या सर्व वैशिष्ट्यांचा लाभ घेण्यासाठी, आम्ही खाते तयार करण्याची शिफारस करतो.
\ No newline at end of file
diff --git a/chapters/mr/chapter 2/2.mdx b/chapters/mr/chapter 2/2.mdx
new file mode 100644
index 000000000..1838d28e3
--- /dev/null
+++ b/chapters/mr/chapter 2/2.mdx
@@ -0,0 +1,232 @@
+
+
+# पाइपलाइनच्या मागे[[behind-the-pipeline]]
+
+
+
+
+
+चला एका संपूर्ण उदाहरणापासून सुरुवात करूया, जेव्हा आपण [प्रकरण 1](/course/chapter1) मध्ये खालील कोड कार्यान्वित केला तेव्हा पडद्यामागे नेमके काय घडले ते पाहूया:
+
+```python
+from transformers import pipeline
+
+classifier = pipeline("sentiment-analysis")
+classifier(
+ [
+ "I've been waiting for a HuggingFace course my whole life.",
+ "I hate this so much!",
+ ]
+)
+```
+
+आणि आपल्याला मिळाले:
+
+```python out
+[{'label': 'POSITIVE', 'score': 0.9598047137260437},
+ {'label': 'NEGATIVE', 'score': 0.9994558095932007}]
+```
+
+[प्रकरण 1](/course/chapter1) मध्ये आपण पाहिल्याप्रमाणे, ही पाइपलाइन तीन टप्पे एकत्र करते: प्रीप्रोसेसिंग, इनपुट्स मॉडेलमधून पाठवणे, आणि पोस्टप्रोसेसिंग:
+
+
+

+

+
+
+चला यापैकी प्रत्येकाचा थोडक्यात आढावा घेऊया.
+
+## टोकनायझरसह प्रीप्रोसेसिंग[[preprocessing-with-a-tokenizer]]
+
+इतर न्यूरल नेटवर्क्सप्रमाणे, ट्रान्सफॉर्मर मॉडेल्स कच्चा मजकूर थेट प्रक्रिया करू शकत नाहीत, म्हणून आपल्या पाइपलाइनचा पहिला टप्पा म्हणजे मजकूर इनपुट्सना अशा संख्यांमध्ये रूपांतरित करणे ज्यांचा मॉडेल अर्थ लावू शकेल. हे करण्यासाठी आपण *टोकनायझर* वापरतो, जो खालील गोष्टींसाठी जबाबदार असेल:
+
+- इनपुटचे शब्द, उपशब्द किंवा चिन्हांमध्ये (जसे की विरामचिन्हे) विभाजन करणे, ज्यांना *टोकन्स* म्हणतात
+- प्रत्येक टोकनला एका पूर्णांकाशी जोडणे
+- मॉडेलसाठी उपयुक्त ठरू शकणारे अतिरिक्त इनपुट्स जोडणे
+
+हे सर्व प्रीप्रोसेसिंग अगदी त्याच पद्धतीने केले जाणे आवश्यक आहे जसे मॉडेलला पूर्व-प्रशिक्षित (pretrained) करताना केले गेले होते, त्यामुळे आपल्याला प्रथम ती माहिती [Model Hub](https://huggingface.co/models) वरून डाउनलोड करावी लागेल. हे करण्यासाठी, आपण `AutoTokenizer` वर्ग आणि त्याची `from_pretrained()` पद्धत वापरतो. आपल्या मॉडेलच्या चेकपॉइंट नावाचा वापर करून, ते आपोआप मॉडेलच्या टोकनायझरशी संबंधित डेटा आणेल आणि तो कॅश करेल (त्यामुळे खालील कोड तुम्ही पहिल्यांदा चालवता तेव्हाच तो डाउनलोड होतो).
+
+`sentiment-analysis` पाइपलाइनचा डीफॉल्ट चेकपॉइंट `distilbert-base-uncased-finetuned-sst-2-english` असल्याने (तुम्ही त्याचे मॉडेल कार्ड [इथे](https://huggingface.co/distilbert-base-uncased-finetuned-sst-2-english) पाहू शकता), आपण खालील कोड चालवतो:
+
+```python
+from transformers import AutoTokenizer
+
+checkpoint = "distilbert-base-uncased-finetuned-sst-2-english"
+tokenizer = AutoTokenizer.from_pretrained(checkpoint)
+```
+
+एकदा आपल्याकडे टोकनायझर आले की, आपण आपली वाक्ये थेट त्याला पाठवू शकतो आणि आपल्याला परत एक डिक्शनरी मिळेल जी आपल्या मॉडेलला देण्यासाठी तयार असेल! आता फक्त इनपुट IDs ची यादी टेन्सर्समध्ये रूपांतरित करणे बाकी आहे.
+
+कोणता ML फ्रेमवर्क बॅकएंड म्हणून वापरला जात आहे याची काळजी न करता तुम्ही 🤗 Transformers वापरू शकता; काही मॉडेल्ससाठी तो PyTorch किंवा Flax असू शकतो. मात्र, ट्रान्सफॉर्मर मॉडेल्स इनपुट म्हणून फक्त *टेन्सर्स* स्वीकारतात. जर तुम्ही टेन्सर्सबद्दल पहिल्यांदाच ऐकत असाल, तर तुम्ही त्यांचा विचार NumPy अॅरे म्हणून करू शकता. NumPy अॅरे स्केलर (0D), वेक्टर (1D), मॅट्रिक्स (2D), किंवा त्याहून अधिक परिमाणांचा असू शकतो. तो प्रभावीपणे एक टेन्सर आहे; इतर ML फ्रेमवर्क्सचे टेन्सर्स सारखेच वागतात, आणि साधारणपणे NumPy अॅरेइतकेच सहज तयार करता येतात.
+
+आपल्याला परत कोणत्या प्रकारचे टेन्सर्स हवे आहेत (PyTorch किंवा साधे NumPy) हे नमूद करण्यासाठी, आपण `return_tensors` आर्ग्युमेंट वापरतो:
+
+```python
+raw_inputs = [
+ "I've been waiting for a HuggingFace course my whole life.",
+ "I hate this so much!",
+]
+inputs = tokenizer(raw_inputs, padding=True, truncation=True, return_tensors="pt")
+print(inputs)
+```
+
+पॅडिंग आणि ट्रंकेशनबद्दल आत्ता काळजी करू नका; आपण त्याबद्दल नंतर स्पष्टीकरण देऊ. इथे लक्षात ठेवण्यासारख्या मुख्य गोष्टी म्हणजे तुम्ही एक वाक्य किंवा वाक्यांची यादी पाठवू शकता, तसेच तुम्हाला परत कोणत्या प्रकारचे टेन्सर्स हवे आहेत हे देखील नमूद करू शकता (जर कोणताही प्रकार दिला नाही, तर तुम्हाला यादींची यादी निकाल म्हणून मिळेल).
+
+PyTorch टेन्सर्स म्हणून निकाल असे दिसतात:
+
+```python out
+{
+ 'input_ids': tensor([
+ [ 101, 1045, 1005, 2310, 2042, 3403, 2005, 1037, 17662, 12172, 2607, 2026, 2878, 2166, 1012, 102],
+ [ 101, 1045, 5223, 2023, 2061, 2172, 999, 102, 0, 0, 0, 0, 0, 0, 0, 0]
+ ]),
+ 'attention_mask': tensor([
+ [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
+ [1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0]
+ ])
+}
+```
+
+आउटपुट स्वतः एक डिक्शनरी आहे ज्यात दोन की आहेत, `input_ids` आणि `attention_mask`. `input_ids` मध्ये पूर्णांकांच्या दोन ओळी आहेत (प्रत्येक वाक्यासाठी एक) ज्या प्रत्येक वाक्यातील टोकन्सचे अद्वितीय ओळखकर्ते आहेत. `attention_mask` म्हणजे काय हे आपण या प्रकरणात नंतर स्पष्ट करू.
+
+## मॉडेलमधून पुढे जाणे[[going-through-the-model]]
+
+आपण आपल्या पूर्व-प्रशिक्षित मॉडेलला त्याच पद्धतीने डाउनलोड करू शकतो जसे आपण आपल्या टोकनायझरसाठी केले. 🤗 Transformers एक `AutoModel` वर्ग पुरवते ज्याची `from_pretrained()` पद्धत देखील आहे:
+
+```python
+from transformers import AutoModel
+
+checkpoint = "distilbert-base-uncased-finetuned-sst-2-english"
+model = AutoModel.from_pretrained(checkpoint)
+```
+
+या कोड स्निपेटमध्ये, आपण आधी आपल्या पाइपलाइनमध्ये वापरलेला तोच चेकपॉइंट डाउनलोड केला आहे (तो प्रत्यक्षात आधीच कॅश झाला असावा) आणि त्याद्वारे एक मॉडेल तयार केले आहे.
+
+या आर्किटेक्चरमध्ये फक्त बेस ट्रान्सफॉर्मर मॉड्यूल आहे: काही इनपुट्स दिल्यावर, ते आउटपुट म्हणून जे देते त्याला आपण *हिडन स्टेट्स* म्हणतो, ज्यांना *फीचर्स* असेही म्हणतात. प्रत्येक मॉडेल इनपुटसाठी, आपल्याला एक उच्च-आयामी (high-dimensional) वेक्टर मिळेल जो **त्या इनपुटची ट्रान्सफॉर्मर मॉडेलद्वारे झालेली संदर्भात्मक समज (contextual understanding)** दर्शवतो.
+
+जर हे समजले नाही, तर काळजी करू नका. आपण हे सर्व नंतर स्पष्ट करू.
+
+हे हिडन स्टेट्स स्वतःहून उपयुक्त असू शकतात, तरी सामान्यतः ते मॉडेलच्या दुसऱ्या भागाचे इनपुट असतात, ज्याला *हेड* म्हणतात. [प्रकरण 1](/course/chapter1) मध्ये, वेगवेगळी कामे त्याच आर्किटेक्चरने केली जाऊ शकली असती, परंतु यापैकी प्रत्येक कामासाठी एक वेगळा हेड जोडलेला असेल.
+
+### एक उच्च-आयामी वेक्टर?[[a-high-dimensional-vector]]
+
+ट्रान्सफॉर्मर मॉड्यूलद्वारे आउटपुट केलेला वेक्टर सामान्यतः मोठा असतो. त्याला साधारणपणे तीन परिमाणे (dimensions) असतात:
+
+- **बॅच साइज**: एका वेळी प्रक्रिया केलेल्या सिक्वेन्सेसची संख्या (आपल्या उदाहरणात 2).
+- **सिक्वेन्स लांबी**: सिक्वेन्सच्या संख्यात्मक प्रतिनिधित्वाची लांबी (आपल्या उदाहरणात 16).
+- **हिडन साइज**: प्रत्येक मॉडेल इनपुटचे वेक्टर परिमाण.
+
+शेवटच्या मूल्यामुळे याला "उच्च-आयामी" म्हटले जाते. हिडन साइज खूप मोठी असू शकते (लहान मॉडेल्ससाठी 768 सामान्य आहे, आणि मोठ्या मॉडेल्समध्ये हे 3072 किंवा त्याहूनही अधिक असू शकते).
+
+आपण आपल्या मॉडेलला प्रीप्रोसेस केलेले इनपुट्स दिल्यास हे आपण पाहू शकतो:
+
+```python
+outputs = model(**inputs)
+print(outputs.last_hidden_state.shape)
+```
+
+```python out
+torch.Size([2, 16, 768])
+```
+
+लक्षात घ्या की 🤗 Transformers मॉडेल्सचे आउटपुट्स `namedtuple`s किंवा डिक्शनरींसारखे वागतात. तुम्ही घटकांना अॅट्रिब्युट्सद्वारे (जसे आपण केले) किंवा की द्वारे (`outputs["last_hidden_state"]`), किंवा तुम्हाला हवी असलेली गोष्ट नेमकी कुठे आहे हे माहीत असल्यास इंडेक्सद्वारे (`outputs[0]`) देखील मिळवू शकता.
+
+### मॉडेल हेड्स: संख्यांचा अर्थ लावणे[[model-heads-making-sense-out-of-numbers]]
+
+मॉडेल हेड्स हिडन स्टेट्सचा उच्च-आयामी वेक्टर इनपुट म्हणून घेतात आणि त्यांना वेगळ्या परिमाणावर प्रोजेक्ट करतात. ते सहसा एक किंवा काही लिनियर लेयर्सने बनलेले असतात:
+
+
+

+

+
+
+ट्रान्सफॉर्मर मॉडेलचे आउटपुट थेट मॉडेल हेडला प्रक्रियेसाठी पाठवले जाते.
+
+या आकृतीमध्ये, मॉडेलचे प्रतिनिधित्व त्याच्या एम्बेडिंग्स लेयरने आणि त्यानंतरच्या लेयर्सने केले आहे. एम्बेडिंग्स लेयर टोकनाइज्ड इनपुटमधील प्रत्येक इनपुट ID ला संबंधित टोकनचे प्रतिनिधित्व करणाऱ्या वेक्टरमध्ये रूपांतरित करते. त्यानंतरचे लेयर्स अटेंशन यंत्रणेचा वापर करून त्या वेक्टर्सवर प्रक्रिया करून वाक्यांचे अंतिम प्रतिनिधित्व तयार करतात.
+
+🤗 Transformers मध्ये अनेक वेगवेगळ्या आर्किटेक्चर्स उपलब्ध आहेत, प्रत्येक एका विशिष्ट कामासाठी डिझाइन केलेले आहे. इथे एक अपूर्ण यादी आहे:
+
+- `*Model` (हिडन स्टेट्स मिळवण्यासाठी)
+- `*ForCausalLM`
+- `*ForMaskedLM`
+- `*ForMultipleChoice`
+- `*ForQuestionAnswering`
+- `*ForSequenceClassification`
+- `*ForTokenClassification`
+- आणि इतर 🤗
+
+आपल्या उदाहरणासाठी, आपल्याला सिक्वेन्स क्लासिफिकेशन हेड असलेले मॉडेल हवे असेल (वाक्यांना पॉझिटिव्ह किंवा निगेटिव्ह म्हणून वर्गीकृत करण्यासाठी). त्यामुळे, आपण प्रत्यक्षात `AutoModel` वर्ग वापरणार नाही, तर `AutoModelForSequenceClassification` वापरू:
+
+```python
+from transformers import AutoModelForSequenceClassification
+
+checkpoint = "distilbert-base-uncased-finetuned-sst-2-english"
+model = AutoModelForSequenceClassification.from_pretrained(checkpoint)
+outputs = model(**inputs)
+```
+
+आता जर आपण आपल्या आउटपुट्सच्या आकाराकडे पाहिले, तर परिमाणता (dimensionality) खूपच कमी असेल: मॉडेल हेड आधी आपण पाहिलेले उच्च-आयामी वेक्टर्स इनपुट म्हणून घेते, आणि दोन मूल्ये (प्रत्येक लेबलसाठी एक) असलेले वेक्टर्स आउटपुट करते:
+
+```python
+print(outputs.logits.shape)
+```
+
+```python out
+torch.Size([2, 2])
+```
+
+आपल्याकडे फक्त दोन वाक्ये आणि दोन लेबल्स असल्याने, आपल्या मॉडेलकडून मिळणारा निकाल 2 x 2 आकाराचा आहे.
+
+## आउटपुटचे पोस्टप्रोसेसिंग[[postprocessing-the-output]]
+
+आपल्या मॉडेलकडून आउटपुट म्हणून मिळणारी मूल्ये स्वतःहून अर्थपूर्ण असतीलच असे नाही. चला पाहूया:
+
+```python
+print(outputs.logits)
+```
+
+```python out
+tensor([[-1.5607, 1.6123],
+ [ 4.1692, -3.3464]], grad_fn=)
+```
+
+आपल्या मॉडेलने पहिल्या वाक्यासाठी `[-1.5607, 1.6123]` आणि दुसऱ्या वाक्यासाठी `[ 4.1692, -3.3464]` भाकीत केले. ती संभाव्यता (probabilities) नाहीत तर *लॉजिट्स* आहेत, म्हणजे मॉडेलच्या शेवटच्या लेयरने आउटपुट केलेले कच्चे, नॉर्मलाइझ न केलेले स्कोअर्स. त्यांना संभाव्यतेमध्ये रूपांतरित करण्यासाठी, त्यांना [SoftMax](https://en.wikipedia.org/wiki/Softmax_function) लेयरमधून जावे लागते (सर्व 🤗 Transformers मॉडेल्स लॉजिट्स आउटपुट करतात, कारण प्रशिक्षणासाठीचे लॉस फंक्शन सहसा शेवटच्या अॅक्टिव्हेशन फंक्शनला, जसे की SoftMax, प्रत्यक्ष लॉस फंक्शनसह, जसे की क्रॉस एंट्रॉपी, एकत्र करते):
+
+```py
+import torch
+
+predictions = torch.nn.functional.softmax(outputs.logits, dim=-1)
+print(predictions)
+```
+
+```python out
+tensor([[4.0195e-02, 9.5980e-01],
+ [9.9946e-01, 5.4418e-04]], grad_fn=)
+```
+
+आता आपण पाहू शकतो की मॉडेलने पहिल्या वाक्यासाठी `[0.0402, 0.9598]` आणि दुसऱ्या वाक्यासाठी `[0.9995, 0.0005]` भाकीत केले. ही ओळखता येण्याजोगी संभाव्यता स्कोअर्स आहेत.
+
+प्रत्येक स्थानाशी संबंधित लेबल्स मिळवण्यासाठी, आपण मॉडेल कॉन्फिगचा `id2label` अॅट्रिब्यूट तपासू शकतो (याबद्दल पुढील विभागात अधिक माहिती):
+
+```python
+model.config.id2label
+```
+
+```python out
+{0: 'NEGATIVE', 1: 'POSITIVE'}
+```
+
+आता आपण असा निष्कर्ष काढू शकतो की मॉडेलने खालील भाकीत केले:
+
+- पहिले वाक्य: NEGATIVE: 0.0402, POSITIVE: 0.9598
+- दुसरे वाक्य: NEGATIVE: 0.9995, POSITIVE: 0.0005
+
+आपण पाइपलाइनचे तीन टप्पे यशस्वीरित्या पुन्हा तयार केले आहेत: टोकनायझर्ससह प्रीप्रोसेसिंग, इनपुट्स मॉडेलमधून पाठवणे, आणि पोस्टप्रोसेसिंग! आता या प्रत्येक टप्प्याचा सखोल अभ्यास करण्यासाठी थोडा वेळ घेऊया.
+
+> [!TIP]
+> ✏️ **करून पहा!** तुमचे स्वतःचे दोन (किंवा अधिक) मजकूर निवडा आणि त्यांना `sentiment-analysis` पाइपलाइनमधून चालवा. मग इथे तुम्ही पाहिलेले टप्पे स्वतः पुन्हा करा आणि तेच निकाल मिळतात का ते तपासा!
\ No newline at end of file
diff --git a/chapters/mr/chapter 2/3.mdx b/chapters/mr/chapter 2/3.mdx
new file mode 100644
index 000000000..3ae9dd1dd
--- /dev/null
+++ b/chapters/mr/chapter 2/3.mdx
@@ -0,0 +1,297 @@
+
+
+# मॉडेल्स[[the-models]]
+
+
+
+
+
+या विभागात, आपण मॉडेल्स तयार करणे आणि वापरणे याबद्दल अधिक सखोलपणे पाहणार आहोत. आपण `AutoModel` वर्ग वापरू, जो एखाद्या चेकपॉइंटवरून कोणतेही मॉडेल इन्स्टंशिएट करायचे असताना उपयुक्त ठरतो.
+
+## ट्रान्सफॉर्मर तयार करणे[[creating-a-transformer]]
+
+आपण `AutoModel` इन्स्टंशिएट केल्यावर काय घडते हे तपासून सुरुवात करूया:
+
+```py
+from transformers import AutoModel
+
+model = AutoModel.from_pretrained("bert-base-cased")
+```
+
+टोकनायझरप्रमाणेच, `from_pretrained()` पद्धत Hugging Face Hub वरून मॉडेल डेटा डाउनलोड करेल आणि कॅश करेल. आधी सांगितल्याप्रमाणे, चेकपॉइंटचे नाव एका विशिष्ट मॉडेल आर्किटेक्चर आणि वेट्सशी संबंधित असते, या प्रकरणात एक BERT मॉडेल ज्याचे मूलभूत आर्किटेक्चर आहे (12 लेयर्स, 768 हिडन साइज, 12 अटेंशन हेड्स) आणि केस्ड इनपुट्स (म्हणजे अप्परकेस/लोअरकेस मधील फरक महत्त्वाचा आहे). Hub वर अनेक चेकपॉइंट्स उपलब्ध आहेत — तुम्ही त्यांना [इथे](https://huggingface.co/models) एक्सप्लोर करू शकता.
+
+`AutoModel` वर्ग आणि त्याचे सहकारी वर्ग प्रत्यक्षात साधे रॅपर्स आहेत जे दिलेल्या चेकपॉइंटसाठी योग्य मॉडेल आर्किटेक्चर आणण्यासाठी डिझाइन केलेले आहेत. हा एक "ऑटो" वर्ग आहे म्हणजेच तो तुमच्यासाठी योग्य मॉडेल आर्किटेक्चरचा अंदाज लावेल आणि योग्य मॉडेल वर्ग इन्स्टंशिएट करेल. मात्र, जर तुम्हाला तुम्ही वापरू इच्छित असलेल्या मॉडेलचा प्रकार माहीत असेल, तर तुम्ही त्याचे आर्किटेक्चर परिभाषित करणारा वर्ग थेट वापरू शकता:
+
+```py
+from transformers import BertModel
+
+model = BertModel.from_pretrained("bert-base-cased")
+```
+
+## लोड करणे आणि जतन करणे[[loading-and-saving]]
+
+मॉडेल जतन करणे टोकनायझर जतन करण्याइतकेच सोपे आहे. खरे तर, मॉडेल्समध्ये देखील तीच `save_pretrained()` पद्धत असते, जी मॉडेलचे वेट्स आणि आर्किटेक्चर कॉन्फिगरेशन जतन करते:
+
+```py
+model.save_pretrained("directory_on_my_computer")
+```
+
+यामुळे तुमच्या डिस्कवर दोन फाइल्स जतन होतील:
+
+```
+ls directory_on_my_computer
+
+config.json model.safetensors
+```
+
+जर तुम्ही *config.json* फाइलमध्ये पाहिले, तर मॉडेल आर्किटेक्चर तयार करण्यासाठी आवश्यक असलेले सर्व अॅट्रिब्यूट्स तुम्हाला दिसतील. या फाइलमध्ये काही मेटाडेटा देखील असतो, जसे की चेकपॉइंट कुठून आले आणि तुम्ही चेकपॉइंट शेवटच्या वेळी जतन केले तेव्हा तुम्ही कोणती 🤗 Transformers आवृत्ती वापरत होता.
+
+*pytorch_model.safetensors* फाइलला स्टेट डिक्शनरी म्हणून ओळखले जाते; त्यात तुमच्या मॉडेलचे सर्व वेट्स असतात. या दोन फाइल्स एकत्र काम करतात: मॉडेल आर्किटेक्चरबद्दल जाणून घेण्यासाठी कॉन्फिगरेशन फाइल आवश्यक असते, तर मॉडेल वेट्स हे मॉडेलचे पॅरामीटर्स असतात.
+
+जतन केलेले मॉडेल पुन्हा वापरण्यासाठी, `from_pretrained()` पद्धत पुन्हा वापरा:
+
+```py
+from transformers import AutoModel
+
+model = AutoModel.from_pretrained("directory_on_my_computer")
+```
+
+🤗 Transformers लायब्ररीचे एक अप्रतिम वैशिष्ट्य म्हणजे मॉडेल्स आणि टोकनायझर्स समुदायासोबत सहजपणे शेअर करण्याची क्षमता. हे करण्यासाठी, तुमच्याकडे [Hugging Face](https://huggingface.co) वर खाते असल्याची खात्री करा. जर तुम्ही नोटबुक वापरत असाल, तर तुम्ही यासह सहजपणे लॉग इन करू शकता:
+
+```python
+from huggingface_hub import notebook_login
+
+notebook_login()
+```
+
+अन्यथा, तुमच्या टर्मिनलवर चालवा:
+
+```bash
+huggingface-cli login
+```
+
+त्यानंतर तुम्ही `push_to_hub()` पद्धतीने मॉडेल Hub वर पुश करू शकता:
+
+```py
+model.push_to_hub("my-awesome-model")
+```
+
+यामुळे मॉडेल फाइल्स Hub वर, तुमच्या नेमस्पेसखाली *my-awesome-model* नावाच्या रिपॉझिटरीमध्ये अपलोड होतील. त्यानंतर, कोणीही `from_pretrained()` पद्धतीने तुमचे मॉडेल लोड करू शकतो!
+
+```py
+from transformers import AutoModel
+
+model = AutoModel.from_pretrained("your-username/my-awesome-model")
+```
+
+तुम्ही Hub API सह आणखी बरेच काही करू शकता:
+- स्थानिक रिपॉझिटरीमधून मॉडेल पुश करणे
+- सर्वकाही पुन्हा अपलोड न करता विशिष्ट फाइल्स अपडेट करणे
+- मॉडेलच्या क्षमता, मर्यादा, ज्ञात पूर्वग्रह इत्यादींचे दस्तऐवजीकरण करण्यासाठी मॉडेल कार्ड्स जोडणे
+
+याबद्दल संपूर्ण ट्युटोरियलसाठी [डॉक्युमेंटेशन](https://huggingface.co/docs/huggingface_hub/how-to-upstream) पहा, किंवा प्रगत [प्रकरण 4](/course/chapter4) पहा.
+
+## मजकूराचे एन्कोडिंग[[encoding-text]]
+
+ट्रान्सफॉर्मर मॉडेल्स इनपुट्सना संख्यांमध्ये रूपांतरित करून मजकूर हाताळतात. इथे आपण तुमचा मजकूर टोकनायझरद्वारे प्रक्रिया केला जातो तेव्हा नेमके काय घडते ते पाहू. [प्रकरण 1](/course/chapter1) मध्ये आपण आधीच पाहिले आहे की टोकनायझर्स मजकुराचे टोकन्समध्ये विभाजन करतात आणि नंतर हे टोकन्स संख्यांमध्ये रूपांतरित करतात. आपण हे रूपांतर एका साध्या टोकनायझरद्वारे पाहू शकतो:
+
+```py
+from transformers import AutoTokenizer
+
+tokenizer = AutoTokenizer.from_pretrained("bert-base-cased")
+
+encoded_input = tokenizer("Hello, I'm a single sentence!")
+print(encoded_input)
+```
+
+```python out
+{'input_ids': [101, 8667, 117, 1000, 1045, 1005, 1049, 2235, 17662, 12172, 1012, 102],
+ 'token_type_ids': [0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
+ 'attention_mask': [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]}
+```
+
+आपल्याला खालील फील्ड्ससह एक डिक्शनरी मिळते:
+- input_ids: तुमच्या टोकन्सचे संख्यात्मक प्रतिनिधित्व
+- token_type_ids: हे मॉडेलला सांगतात की इनपुटचा कोणता भाग वाक्य A आहे आणि कोणता वाक्य B आहे (पुढील विभागात याबद्दल अधिक चर्चा होईल)
+- attention_mask: हे दर्शवते की कोणत्या टोकन्सकडे लक्ष द्यायचे आणि कोणत्या टोकन्सकडे नाही (याबद्दल थोड्याच वेळात अधिक चर्चा होईल)
+
+आपण मूळ मजकूर परत मिळवण्यासाठी इनपुट IDs डीकोड करू शकतो:
+
+```py
+tokenizer.decode(encoded_input["input_ids"])
+```
+
+```python out
+"[CLS] Hello, I'm a single sentence! [SEP]"
+```
+
+तुमच्या लक्षात येईल की टोकनायझरने `[CLS]` आणि `[SEP]` हे विशेष टोकन्स जोडले आहेत — जे मॉडेलसाठी आवश्यक असतात. सर्वच मॉडेल्सना विशेष टोकन्सची गरज नसते; जेव्हा एखादे मॉडेल त्यांच्यासह पूर्व-प्रशिक्षित केले गेले असते तेव्हाच ते वापरले जातात, अशा परिस्थितीत टोकनायझरला ते जोडावे लागतात कारण मॉडेल त्या टोकन्सची अपेक्षा करते.
+
+तुम्ही एकाच वेळी अनेक वाक्ये एन्कोड करू शकता, एकतर त्यांना एकत्र बॅच करून (आपण याबद्दल लवकरच चर्चा करू) किंवा यादी पाठवून:
+
+```py
+encoded_input = tokenizer("How are you?", "I'm fine, thank you!")
+print(encoded_input)
+```
+
+```python out
+{'input_ids': [[101, 1731, 1132, 1128, 136, 102], [101, 1045, 1005, 1049, 2503, 117, 5763, 1128, 136, 102]],
+ 'token_type_ids': [[0, 0, 0, 0, 0, 0], [0, 0, 0, 0, 0, 0, 0, 0, 0, 0]],
+ 'attention_mask': [[1, 1, 1, 1, 1, 1], [1, 1, 1, 1, 1, 1, 1, 1, 1, 1]]}
+```
+
+लक्षात घ्या की अनेक वाक्ये पाठवताना, टोकनायझर प्रत्येक डिक्शनरी व्हॅल्यूसाठी प्रत्येक वाक्यासाठी एक यादी परत करतो. आपण टोकनायझरला थेट PyTorch मधून टेन्सर्स परत करण्यासही सांगू शकतो:
+
+```py
+encoded_input = tokenizer("How are you?", "I'm fine, thank you!", return_tensors="pt")
+print(encoded_input)
+```
+
+```python out
+{'input_ids': tensor([[ 101, 1731, 1132, 1128, 136, 102],
+ [ 101, 1045, 1005, 1049, 2503, 117, 5763, 1128, 136, 102]]),
+ 'token_type_ids': tensor([[0, 0, 0, 0, 0, 0],
+ [0, 0, 0, 0, 0, 0, 0, 0, 0, 0]]),
+ 'attention_mask': tensor([[1, 1, 1, 1, 1, 1],
+ [1, 1, 1, 1, 1, 1, 1, 1, 1, 1]])}
+```
+
+पण इथे एक समस्या आहे: दोन्ही यादींची लांबी सारखी नाही! अॅरे आणि टेन्सर्स आयताकृती (rectangular) असणे आवश्यक आहे, त्यामुळे आपण या याद्यांना सहजपणे PyTorch टेन्सरमध्ये (किंवा NumPy अॅरेमध्ये) रूपांतरित करू शकत नाही. टोकनायझर यासाठी एक पर्याय पुरवतो: पॅडिंग.
+
+### इनपुट्सचे पॅडिंग[[padding-inputs]]
+
+जर आपण टोकनायझरला इनपुट्स पॅड करण्यास सांगितले, तर सर्वात लांब वाक्यापेक्षा लहान असलेल्या वाक्यांना एक विशेष पॅडिंग टोकन जोडून तो सर्व वाक्यांची लांबी सारखी करेल:
+
+```py
+encoded_input = tokenizer(
+ ["How are you?", "I'm fine, thank you!"], padding=True, return_tensors="pt"
+)
+print(encoded_input)
+```
+
+```python out
+{'input_ids': tensor([[ 101, 1731, 1132, 1128, 136, 102, 0, 0, 0, 0],
+ [ 101, 1045, 1005, 1049, 2503, 117, 5763, 1128, 136, 102]]),
+ 'token_type_ids': tensor([[0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
+ [0, 0, 0, 0, 0, 0, 0, 0, 0, 0]]),
+ 'attention_mask': tensor([[1, 1, 1, 1, 1, 1, 0, 0, 0, 0],
+ [1, 1, 1, 1, 1, 1, 1, 1, 1, 1]])}
+```
+
+आता आपल्याकडे आयताकृती टेन्सर्स आहेत! लक्षात घ्या की पॅडिंग टोकन्स ID 0 सह इनपुट IDs मध्ये एन्कोड केले गेले आहेत, आणि त्यांचे अटेंशन मास्क मूल्य देखील 0 आहे. याचे कारण असे की त्या पॅडिंग टोकन्सचे मॉडेलद्वारे विश्लेषण होऊ नये: ते प्रत्यक्ष वाक्याचा भाग नाहीत.
+
+### इनपुट्सचे ट्रंकेशन[[truncating-inputs]]
+
+टेन्सर्स मॉडेलद्वारे प्रक्रिया करण्यासाठी खूप मोठे होऊ शकतात. उदाहरणार्थ, BERT फक्त 512 टोकन्सपर्यंतच्या सिक्वेन्सेससह पूर्व-प्रशिक्षित केले गेले होते, त्यामुळे ते त्याहून लांब सिक्वेन्सेस प्रक्रिया करू शकत नाही. जर तुमच्याकडे मॉडेल हाताळू शकेल त्यापेक्षा लांब सिक्वेन्सेस असतील, तर तुम्हाला त्यांना `truncation` पॅरामीटरने ट्रंकेट करावे लागेल:
+
+```py
+encoded_input = tokenizer(
+ "This is a very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very very long sentence.",
+ truncation=True,
+)
+print(encoded_input["input_ids"])
+```
+
+```python out
+[101, 1188, 1110, 170, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1505, 1179, 5650, 119, 102]
+```
+
+पॅडिंग आणि ट्रंकेशन आर्ग्युमेंट्स एकत्र करून, तुम्ही तुमच्या टेन्सर्सना तुम्हाला हव्या असलेल्या नेमक्या आकाराचे बनवू शकता:
+
+```py
+encoded_input = tokenizer(
+ ["How are you?", "I'm fine, thank you!"],
+ padding=True,
+ truncation=True,
+ max_length=5,
+ return_tensors="pt",
+)
+print(encoded_input)
+```
+
+```python out
+{'input_ids': tensor([[ 101, 1731, 1132, 1128, 102],
+ [ 101, 1045, 1005, 1049, 102]]),
+ 'token_type_ids': tensor([[0, 0, 0, 0, 0],
+ [0, 0, 0, 0, 0]]),
+ 'attention_mask': tensor([[1, 1, 1, 1, 1],
+ [1, 1, 1, 1, 1]])}
+```
+
+### विशेष टोकन्स जोडणे
+
+विशेष टोकन्स (किंवा किमान त्यांची संकल्पना) BERT आणि त्यापासून तयार झालेल्या मॉडेल्ससाठी विशेषतः महत्त्वाची आहे. वाक्याच्या सीमा अधिक चांगल्या प्रकारे दर्शवण्यासाठी हे टोकन्स जोडले जातात, जसे की वाक्याची सुरुवात (`[CLS]`) किंवा वाक्यांमधील विभाजक (`[SEP]`). चला एक साधे उदाहरण पाहूया:
+
+```py
+encoded_input = tokenizer("How are you?")
+print(encoded_input["input_ids"])
+tokenizer.decode(encoded_input["input_ids"])
+```
+
+```python out
+[101, 1731, 1132, 1128, 136, 102]
+'[CLS] How are you? [SEP]'
+```
+
+हे विशेष टोकन्स टोकनायझरद्वारे आपोआप जोडले जातात. सर्वच मॉडेल्सना विशेष टोकन्सची गरज नसते; जेव्हा एखादे मॉडेल त्यांच्यासह पूर्व-प्रशिक्षित केले गेले असते तेव्हाच ते प्रामुख्याने वापरले जातात, अशा परिस्थितीत टोकनायझर त्यांना जोडेल कारण मॉडेल त्यांची अपेक्षा करते.
+
+### हे सर्व का आवश्यक आहे?
+
+इथे एक ठोस उदाहरण आहे. या एन्कोड केलेल्या सिक्वेन्सेसचा विचार करा:
+
+```py
+sequences = [
+ "I've been waiting for a HuggingFace course my whole life.",
+ "I hate this so much!",
+]
+```
+
+एकदा टोकनाइझ केल्यावर, आपल्याकडे हे असते:
+
+```python
+encoded_sequences = [
+ [
+ 101,
+ 1045,
+ 1005,
+ 2310,
+ 2042,
+ 3403,
+ 2005,
+ 1037,
+ 17662,
+ 12172,
+ 2607,
+ 2026,
+ 2878,
+ 2166,
+ 1012,
+ 102,
+ ],
+ [101, 1045, 5223, 2023, 2061, 2172, 999, 102],
+]
+```
+
+ही एन्कोड केलेल्या सिक्वेन्सेसची यादी आहे: यादींची यादी. टेन्सर्स फक्त आयताकृती आकार (matrices चा विचार करा) स्वीकारतात. हे "अॅरे" आधीच आयताकृती आकाराचे आहे, त्यामुळे त्याला टेन्सरमध्ये रूपांतरित करणे सोपे आहे:
+
+```py
+import torch
+
+model_inputs = torch.tensor(encoded_sequences)
+```
+
+### टेन्सर्सचा मॉडेलसाठी इनपुट म्हणून वापर[[using-the-tensors-as-inputs-to-the-model]]
+
+मॉडेलसह टेन्सर्सचा वापर करणे अत्यंत सोपे आहे — आपण फक्त इनपुट्ससह मॉडेल कॉल करतो:
+
+```py
+output = model(model_inputs)
+```
+
+मॉडेल अनेक वेगवेगळे आर्ग्युमेंट्स स्वीकारत असले तरी, फक्त इनपुट IDs आवश्यक असतात. इतर आर्ग्युमेंट्स काय करतात आणि ते कधी आवश्यक असतात हे आपण नंतर स्पष्ट करू,
+पण आधी आपल्याला ट्रान्सफॉर्मर मॉडेल समजू शकेल असे इनपुट्स तयार करणाऱ्या टोकनायझर्सकडे अधिक सखोलपणे पाहणे आवश्यक आहे.
\ No newline at end of file
diff --git a/chapters/mr/chapter 2/4.mdx b/chapters/mr/chapter 2/4.mdx
new file mode 100644
index 000000000..7e35edd8e
--- /dev/null
+++ b/chapters/mr/chapter 2/4.mdx
@@ -0,0 +1,218 @@
+
+
+# टोकनायझर्स[[tokenizers]]
+
+
+
+
+
+टोकनायझर्स हे NLP पाइपलाइनच्या मुख्य घटकांपैकी एक आहेत. त्यांचा एकच उद्देश असतो: मजकुराचे रूपांतर मॉडेलद्वारे प्रक्रिया करता येईल अशा डेटामध्ये करणे. मॉडेल्स फक्त संख्यांवर प्रक्रिया करू शकतात, त्यामुळे टोकनायझर्सना आपल्या मजकूर इनपुट्सना संख्यात्मक डेटामध्ये रूपांतरित करावे लागते. या विभागात, आपण टोकनायझेशन पाइपलाइनमध्ये नेमके काय घडते ते पाहणार आहोत.
+
+NLP कामांमध्ये, सामान्यतः जो डेटा प्रक्रिया केला जातो तो कच्चा मजकूर असतो. अशा मजकुराचे एक उदाहरण इथे आहे:
+
+```
+Jim Henson was a puppeteer
+```
+
+मात्र, मॉडेल्स फक्त संख्यांवरच प्रक्रिया करू शकतात, त्यामुळे आपल्याला कच्च्या मजकुराला संख्यांमध्ये रूपांतरित करण्याचा मार्ग शोधावा लागतो. टोकनायझर्स नेमके हेच करतात, आणि हे करण्याचे अनेक मार्ग आहेत. सर्वात अर्थपूर्ण प्रतिनिधित्व शोधणे — म्हणजेच, मॉडेलसाठी सर्वात अर्थपूर्ण असलेले — आणि शक्य असल्यास, सर्वात लहान प्रतिनिधित्व शोधणे हे उद्दिष्ट असते.
+
+चला टोकनायझेशन अल्गोरिदम्सची काही उदाहरणे पाहूया, आणि टोकनायझेशनबद्दल तुम्हाला असलेल्या काही प्रश्नांची उत्तरे देण्याचा प्रयत्न करूया.
+
+## शब्द-आधारित (Word-based)[[word-based]]
+
+
+
+मनात येणारा पहिला प्रकारचा टोकनायझर म्हणजे _शब्द-आधारित_ (word-based) टोकनायझर. तो सामान्यतः फक्त काही नियमांसह सेट करणे आणि वापरणे खूप सोपे असते, आणि तो बऱ्याचदा योग्य निकाल देतो. उदाहरणार्थ, खालील चित्रात, कच्च्या मजकुराचे शब्दांमध्ये विभाजन करणे आणि प्रत्येकासाठी एक संख्यात्मक प्रतिनिधित्व शोधणे हे उद्दिष्ट आहे:
+
+
+

+

+
+
+मजकुराचे विभाजन करण्याचे वेगवेगळे मार्ग आहेत. उदाहरणार्थ, आपण Python च्या `split()` फंक्शनचा वापर करून व्हाइटस्पेसच्या आधारे मजकूराला शब्दांमध्ये टोकनाइझ करू शकतो:
+
+```py
+tokenized_text = "Jim Henson was a puppeteer".split()
+print(tokenized_text)
+```
+
+```python out
+['Jim', 'Henson', 'was', 'a', 'puppeteer']
+```
+
+शब्द टोकनायझर्सचे काही प्रकार असेही आहेत ज्यांच्यात विरामचिन्हांसाठी अतिरिक्त नियम असतात. या प्रकारच्या टोकनायझरसह, आपल्याकडे काही अगदी मोठे "व्होकॅब्युलरीज" (शब्दसंग्रह) असू शकतात, जिथे व्होकॅब्युलरी म्हणजे आपल्या कॉर्पसमध्ये असलेल्या स्वतंत्र टोकन्सची एकूण संख्या.
+
+प्रत्येक शब्दाला 0 पासून सुरू होऊन व्होकॅब्युलरीच्या आकारापर्यंत एक ID दिले जाते. मॉडेल प्रत्येक शब्द ओळखण्यासाठी या IDs चा वापर करते.
+
+जर आपल्याला शब्द-आधारित टोकनायझरने एखादी भाषा पूर्णपणे कव्हर करायची असेल, तर आपल्याला त्या भाषेतील प्रत्येक शब्दासाठी एक ओळखकर्ता (identifier) असणे आवश्यक असते, ज्यामुळे खूप मोठ्या प्रमाणात टोकन्स तयार होतील. उदाहरणार्थ, इंग्रजी भाषेत 500,000 पेक्षा जास्त शब्द आहेत, त्यामुळे प्रत्येक शब्दापासून इनपुट ID पर्यंतचा नकाशा तयार करण्यासाठी आपल्याला तितक्या IDs चा मागोवा ठेवावा लागेल. शिवाय, "dog" सारखे शब्द "dogs" सारख्या शब्दांपेक्षा वेगळ्या प्रकारे दर्शवले जातात, आणि मॉडेलला सुरुवातीला "dog" आणि "dogs" समान आहेत हे कळण्याचा कोणताही मार्ग नसतो: ते दोन्ही शब्दांना असंबंधित म्हणून ओळखेल. "run" आणि "running" सारख्या इतर समान शब्दांबाबतही असेच घडते, जे मॉडेलला सुरुवातीला समान असल्याचे दिसणार नाही.
+
+शेवटी, आपल्या व्होकॅब्युलरीमध्ये नसलेल्या शब्दांचे प्रतिनिधित्व करण्यासाठी आपल्याला एक कस्टम टोकन आवश्यक असतो. याला "unknown" टोकन म्हणून ओळखले जाते, जे सहसा "[UNK]" किंवा "<unk>" म्हणून दर्शवले जाते. जर तुम्हाला टोकनायझर यापैकी बरेच टोकन्स तयार करत असल्याचे दिसले, तर हे सहसा वाईट लक्षण असते, कारण त्याला एखाद्या शब्दाचे अर्थपूर्ण प्रतिनिधित्व मिळवता आले नाही आणि तुम्ही या प्रक्रियेत माहिती गमावत आहात. व्होकॅब्युलरी तयार करताना उद्दिष्ट असे असते की टोकनायझर शक्य तितक्या कमी शब्दांना unknown टोकनमध्ये टोकनाइझ करेल.
+
+unknown टोकन्सचे प्रमाण कमी करण्याचा एक मार्ग म्हणजे आणखी एक पातळी खोलात जाऊन, _कॅरॅक्टर-आधारित_ (character-based) टोकनायझर वापरणे.
+
+## कॅरॅक्टर-आधारित (Character-based)[[character-based]]
+
+
+
+कॅरॅक्टर-आधारित टोकनायझर्स मजकुराचे शब्दांऐवजी कॅरॅक्टर्समध्ये विभाजन करतात. याचे दोन प्रमुख फायदे आहेत:
+
+- व्होकॅब्युलरी खूपच लहान असते.
+- आउट-ऑफ-व्होकॅब्युलरी (unknown) टोकन्स खूपच कमी असतात, कारण प्रत्येक शब्द कॅरॅक्टर्सपासून तयार करता येतो.
+
+पण इथेही स्पेसेस आणि विरामचिन्हांबाबत काही प्रश्न उद्भवतात:
+
+
+

+

+
+
+हा दृष्टिकोनही परिपूर्ण नाही. कारण आता प्रतिनिधित्व शब्दांऐवजी कॅरॅक्टर्सवर आधारित आहे, त्यामुळे कोणीही असा युक्तिवाद करू शकतो की, सहज विचार केल्यास, ते कमी अर्थपूर्ण आहे: प्रत्येक कॅरॅक्टरचा स्वतःहून फारसा अर्थ नसतो, तर शब्दांच्या बाबतीत तसे असते. मात्र, हे पुन्हा भाषेनुसार वेगळे असते; उदाहरणार्थ, चिनी भाषेत, प्रत्येक कॅरॅक्टर लॅटिन भाषेतील कॅरॅक्टरपेक्षा अधिक माहिती वाहून नेतो.
+
+आणखी एक गोष्ट लक्षात घेण्यासारखी म्हणजे आपल्या मॉडेलद्वारे प्रक्रिया करण्यासाठी आपल्याकडे खूप मोठ्या प्रमाणात टोकन्स असतील: शब्द-आधारित टोकनायझरसह एक शब्द फक्त एकच टोकन असतो, तर तोच शब्द कॅरॅक्टर्समध्ये रूपांतरित केल्यावर सहजपणे 10 किंवा त्याहून अधिक टोकन्समध्ये बदलू शकतो.
+
+दोन्हीचा सर्वोत्तम भाग मिळवण्यासाठी, आपण या दोन्ही पद्धतींना एकत्र करणारे तिसरे तंत्र वापरू शकतो: *सबवर्ड टोकनायझेशन*.
+
+## सबवर्ड टोकनायझेशन[[subword-tokenization]]
+
+
+
+सबवर्ड टोकनायझेशन अल्गोरिदम्स या तत्त्वावर अवलंबून असतात की वारंवार वापरले जाणारे शब्द लहान सबवर्ड्समध्ये विभागले जाऊ नयेत, परंतु दुर्मिळ शब्दांना अर्थपूर्ण सबवर्ड्समध्ये विभागले जावे.
+
+उदाहरणार्थ, "annoyingly" हा एक दुर्मिळ शब्द मानला जाऊ शकतो आणि त्याचे "annoying" आणि "ly" असे विभाजन केले जाऊ शकते. हे दोन्ही स्वतंत्र सबवर्ड्स म्हणून अधिक वारंवार दिसण्याची शक्यता असते, आणि त्याच वेळी "annoyingly" चा अर्थ "annoying" आणि "ly" च्या एकत्रित अर्थाद्वारे कायम राहतो.
+
+इथे एक उदाहरण आहे जे दाखवते की सबवर्ड टोकनायझेशन अल्गोरिदम "Let's do tokenization!" या सिक्वेन्सला कसे टोकनाइझ करेल:
+
+
+

+

+
+
+हे सबवर्ड्स भरपूर सिमॅंटिक अर्थ पुरवतात: उदाहरणार्थ, वरील उदाहरणात "tokenization" चे "token" आणि "ization" असे विभाजन झाले, हे दोन्ही टोकन्स सिमॅंटिक अर्थ राखतात आणि त्याच वेळी स्पेस-कार्यक्षम असतात (एक लांब शब्द दर्शवण्यासाठी फक्त दोनच टोकन्स आवश्यक असतात). यामुळे आपल्याला लहान व्होकॅब्युलरीजसह तुलनेने चांगले कव्हरेज मिळते, आणि जवळजवळ कोणतेही unknown टोकन्स राहत नाहीत.
+
+हा दृष्टिकोन विशेषतः तुर्की सारख्या agglutinative भाषांमध्ये उपयुक्त ठरतो, जिथे तुम्ही सबवर्ड्स एकत्र जोडून (जवळजवळ) कितीही लांब जटिल शब्द तयार करू शकता.
+
+### आणि आणखी बरेच काही![[and-more]]
+
+अपेक्षेप्रमाणे, अशा आणखी बऱ्याच तंत्रे उपलब्ध आहेत. काही उदाहरणे:
+
+- Byte-level BPE, जे GPT-2 मध्ये वापरले जाते
+- WordPiece, जे BERT मध्ये वापरले जाते
+- SentencePiece किंवा Unigram, जे अनेक बहुभाषिक मॉडेल्समध्ये वापरले जातात
+
+आता तुम्हाला टोकनायझर्स कसे कार्य करतात याबद्दल API सह सुरुवात करण्यासाठी पुरेसे ज्ञान मिळाले असेल.
+
+## लोड करणे आणि जतन करणे[[loading-and-saving]]
+
+टोकनायझर्स लोड करणे आणि जतन करणे मॉडेल्ससाठी करण्याइतकेच सोपे आहे. खरे तर, हे त्याच दोन पद्धतींवर आधारित आहे: `from_pretrained()` आणि `save_pretrained()`. या पद्धती टोकनायझरने वापरलेला अल्गोरिदम (मॉडेलच्या *आर्किटेक्चर* सारखा) तसेच त्याची व्होकॅब्युलरी (मॉडेलच्या *वेट्स* सारखी) लोड किंवा जतन करतील.
+
+BERT प्रमाणेच त्याच चेकपॉइंटसह प्रशिक्षित केलेला BERT टोकनायझर लोड करणे मॉडेल लोड करण्याप्रमाणेच केले जाते, फक्त आपण `BertTokenizer` वर्ग वापरतो:
+
+```py
+from transformers import BertTokenizer
+
+tokenizer = BertTokenizer.from_pretrained("bert-base-cased")
+```
+
+`AutoModel` प्रमाणेच, `AutoTokenizer` वर्ग चेकपॉइंट नावाच्या आधारे लायब्ररीतील योग्य टोकनायझर वर्ग घेईल, आणि कोणत्याही चेकपॉइंटसह थेट वापरता येईल:
+
+```py
+from transformers import AutoTokenizer
+
+tokenizer = AutoTokenizer.from_pretrained("bert-base-cased")
+```
+
+आता आपण मागील विभागात दाखवल्याप्रमाणे टोकनायझर वापरू शकतो:
+
+```python
+tokenizer("Using a Transformer network is simple")
+```
+
+```python out
+{'input_ids': [101, 7993, 170, 11303, 1200, 2443, 1110, 3014, 102],
+ 'token_type_ids': [0, 0, 0, 0, 0, 0, 0, 0, 0],
+ 'attention_mask': [1, 1, 1, 1, 1, 1, 1, 1, 1]}
+```
+
+टोकनायझर जतन करणे मॉडेल जतन करण्यासारखेच आहे:
+
+```py
+tokenizer.save_pretrained("directory_on_my_computer")
+```
+
+आपण `token_type_ids` बद्दल [प्रकरण 3](/course/chapter3) मध्ये अधिक चर्चा करू, आणि `attention_mask` की बद्दल थोड्याच वेळात स्पष्टीकरण देऊ. प्रथम, `input_ids` कशा प्रकारे तयार होतात हे पाहूया. हे करण्यासाठी, आपल्याला टोकनायझरच्या मध्यवर्ती (intermediate) पद्धतींकडे पाहावे लागेल.
+
+## एन्कोडिंग[[encoding]]
+
+
+
+मजकुराचे संख्यांमध्ये रूपांतर करणे याला _एन्कोडिंग_ म्हणून ओळखले जाते. एन्कोडिंग दोन-टप्प्यांच्या प्रक्रियेत केले जाते: टोकनायझेशन, त्यानंतर इनपुट IDs मध्ये रूपांतरण.
+
+आपण पाहिल्याप्रमाणे, पहिला टप्पा म्हणजे मजकुराचे शब्दांमध्ये (किंवा शब्दांच्या भागांमध्ये, विरामचिन्हांमध्ये इत्यादी) विभाजन करणे, ज्यांना सहसा *टोकन्स* म्हणतात. या प्रक्रियेवर नियंत्रण ठेवणारे अनेक नियम असू शकतात, म्हणूनच आपल्याला मॉडेलच्या नावाचा वापर करून टोकनायझर इन्स्टंशिएट करावा लागतो, जेणेकरून मॉडेल पूर्व-प्रशिक्षित करताना वापरलेले तेच नियम आपण वापरत आहोत याची खात्री होईल.
+
+दुसरा टप्पा म्हणजे त्या टोकन्सना संख्यांमध्ये रूपांतरित करणे, जेणेकरून आपण त्यांच्यापासून एक टेन्सर तयार करू शकू आणि मॉडेलला देऊ शकू. हे करण्यासाठी, टोकनायझरकडे एक *व्होकॅब्युलरी* असते, जो भाग आपण `from_pretrained()` पद्धतीने इन्स्टंशिएट करताना डाउनलोड करतो. पुन्हा, मॉडेल पूर्व-प्रशिक्षित करताना वापरलेली तीच व्होकॅब्युलरी आपल्याला वापरावी लागते.
+
+या दोन्ही टप्प्यांची अधिक चांगली समज मिळवण्यासाठी, आपण त्यांना स्वतंत्रपणे एक्सप्लोर करू. लक्षात घ्या की टोकनायझेशन पाइपलाइनच्या काही भागांना स्वतंत्रपणे पार पाडणाऱ्या काही पद्धती आपण वापरणार आहोत जेणेकरून त्या टप्प्यांचे मध्यवर्ती निकाल तुम्हाला दाखवता येतील, परंतु प्रत्यक्ष व्यवहारात, तुम्ही टोकनायझरला थेट तुमच्या इनपुट्सवर कॉल करावे (जसे विभाग 2 मध्ये दाखवले होते).
+
+### टोकनायझेशन[[tokenization]]
+
+टोकनायझेशन प्रक्रिया टोकनायझरच्या `tokenize()` पद्धतीद्वारे केली जाते:
+
+```py
+from transformers import AutoTokenizer
+
+tokenizer = AutoTokenizer.from_pretrained("bert-base-cased")
+
+sequence = "Using a Transformer network is simple"
+tokens = tokenizer.tokenize(sequence)
+
+print(tokens)
+```
+
+या पद्धतीचे आउटपुट स्ट्रिंग्सची, म्हणजेच टोकन्सची, एक यादी आहे:
+
+```python out
+['Using', 'a', 'transform', '##er', 'network', 'is', 'simple']
+```
+
+हा टोकनायझर एक सबवर्ड टोकनायझर आहे: तो शब्दांचे विभाजन तोपर्यंत करतो जोपर्यंत त्याला त्याच्या व्होकॅब्युलरीद्वारे दर्शवता येतील असे टोकन्स मिळत नाहीत. `transformer` च्या बाबतीत इथे नेमके हेच घडते, ज्याचे दोन टोकन्समध्ये विभाजन होते: `transform` आणि `##er`.
+
+### टोकन्सपासून इनपुट IDs पर्यंत[[from-tokens-to-input-ids]]
+
+इनपुट IDs मध्ये रूपांतरण `convert_tokens_to_ids()` या टोकनायझर पद्धतीद्वारे हाताळले जाते:
+
+```py
+ids = tokenizer.convert_tokens_to_ids(tokens)
+
+print(ids)
+```
+
+```python out
+[7993, 170, 11303, 1200, 2443, 1110, 3014]
+```
+
+हे आउटपुट्स, योग्य फ्रेमवर्क टेन्सरमध्ये रूपांतरित केल्यावर, या प्रकरणात आधी पाहिल्याप्रमाणे मॉडेलसाठी इनपुट म्हणून वापरता येतात.
+
+> [!TIP]
+> ✏️ **करून पहा!** विभाग 2 मध्ये आपण वापरलेल्या इनपुट वाक्यांवर ("I've been waiting for a HuggingFace course my whole life." आणि "I hate this so much!") शेवटचे दोन टप्पे (टोकनायझेशन आणि इनपुट IDs मध्ये रूपांतरण) पुन्हा करा. आपल्याला आधी मिळालेल्या तशाच इनपुट IDs मिळतात का ते तपासा!
+
+## डीकोडिंग[[decoding]]
+
+*डीकोडिंग* म्हणजे उलट दिशेने जाणे: व्होकॅब्युलरी इंडेक्सेसपासून, आपल्याला एक स्ट्रिंग मिळवायची आहे. हे `decode()` पद्धतीने खालीलप्रमाणे करता येते:
+
+```py
+decoded_string = tokenizer.decode([7993, 170, 11303, 1200, 2443, 1110, 3014])
+print(decoded_string)
+```
+
+```python out
+'Using a Transformer network is simple'
+```
+
+लक्षात घ्या की `decode` पद्धत फक्त इंडेक्सेसना परत टोकन्समध्ये रूपांतरित करत नाही, तर एका वाचनीय वाक्याची निर्मिती करण्यासाठी त्याच शब्दांचा भाग असलेल्या टोकन्सना एकत्र देखील गटबद्ध करते. नवीन मजकूर भाकीत करणारी मॉडेल्स वापरताना (एकतर प्रॉम्प्टमधून तयार केलेला मजकूर, किंवा भाषांतर किंवा सारांशीकरणासारख्या सिक्वेन्स-टू-सिक्वेन्स समस्यांसाठी) हे वर्तन अत्यंत उपयुक्त ठरेल.
+
+आतापर्यंत तुम्हाला टोकनायझर हाताळू शकणाऱ्या मूलभूत क्रिया समजल्या असतील: टोकनायझेशन, IDs मध्ये रूपांतरण, आणि IDs परत स्ट्रिंगमध्ये रूपांतरण. मात्र, आपण नुकतीच हिमनगाची फक्त टोक (tip of the iceberg) पाहिली आहे. पुढील विभागात, आपण आपला दृष्टिकोन त्याच्या मर्यादांपर्यंत नेऊ आणि त्यावर मात कशी करायची ते पाहू.
\ No newline at end of file
diff --git a/chapters/mr/chapter 2/5.mdx b/chapters/mr/chapter 2/5.mdx
new file mode 100644
index 000000000..38962246f
--- /dev/null
+++ b/chapters/mr/chapter 2/5.mdx
@@ -0,0 +1,200 @@
+
+
+# अनेक सिक्वेन्सेस हाताळणे[[handling-multiple-sequences]]
+
+
+
+
+
+मागील विभागात, आपण सर्वात सोप्या वापर प्रकरणाचा शोध घेतला: लहान लांबीच्या एका सिक्वेन्सवर इन्फरन्स करणे. मात्र, आधीच काही प्रश्न उद्भवतात:
+
+- आपण अनेक सिक्वेन्सेस कशा हाताळतो?
+- आपण *वेगवेगळ्या लांबीच्या* अनेक सिक्वेन्सेस कशा हाताळतो?
+- व्होकॅब्युलरी इंडेक्सेस हेच फक्त असे इनपुट्स आहेत का जे मॉडेलला व्यवस्थित काम करू देतात?
+- खूप लांब सिक्वेन्स असे काही असते का?
+
+चला या प्रश्नांमुळे कोणत्या प्रकारच्या समस्या निर्माण होतात, आणि 🤗 Transformers API वापरून आपण त्या कशा सोडवू शकतो ते पाहूया.
+
+## मॉडेल्सना इनपुट्सचा एक बॅच अपेक्षित असतो[[models-expect-a-batch-of-inputs]]
+
+मागील सरावात तुम्ही पाहिले की सिक्वेन्सेसचे रूपांतर संख्यांच्या याद्यांमध्ये कसे होते. चला या संख्यांच्या यादीला टेन्सरमध्ये रूपांतरित करू आणि मॉडेलला पाठवू:
+
+```py
+import torch
+from transformers import AutoTokenizer, AutoModelForSequenceClassification
+
+checkpoint = "distilbert-base-uncased-finetuned-sst-2-english"
+tokenizer = AutoTokenizer.from_pretrained(checkpoint)
+model = AutoModelForSequenceClassification.from_pretrained(checkpoint)
+
+sequence = "I've been waiting for a HuggingFace course my whole life."
+
+tokens = tokenizer.tokenize(sequence)
+ids = tokenizer.convert_tokens_to_ids(tokens)
+input_ids = torch.tensor(ids)
+# This line will fail.
+model(input_ids)
+```
+
+```python out
+IndexError: Dimension out of range (expected to be in range of [-1, 0], but got 1)
+```
+
+अरे नाही! हे का अयशस्वी झाले? आपण विभाग 2 मधील पाइपलाइनचे टप्पे पाळले होते.
+
+समस्या अशी आहे की आपण मॉडेलला एक एकच सिक्वेन्स पाठवला, तर 🤗 Transformers मॉडेल्सना डीफॉल्टनुसार अनेक वाक्ये अपेक्षित असतात. इथे आपण `sequence` वर टोकनायझर लागू केला तेव्हा टोकनायझरने पडद्यामागे केलेले सर्वकाही स्वतः करण्याचा प्रयत्न केला. पण जर तुम्ही बारकाईने पाहिले, तर तुमच्या लक्षात येईल की टोकनायझरने फक्त इनपुट IDs च्या यादीचे टेन्सरमध्ये रूपांतर केले नाही, तर त्याने त्यावर एक अतिरिक्त डायमेंशन जोडले:
+
+```py
+tokenized_inputs = tokenizer(sequence, return_tensors="pt")
+print(tokenized_inputs["input_ids"])
+```
+
+```python out
+tensor([[ 101, 1045, 1005, 2310, 2042, 3403, 2005, 1037, 17662, 12172,
+ 2607, 2026, 2878, 2166, 1012, 102]])
+```
+
+चला पुन्हा प्रयत्न करूया आणि एक नवीन डायमेंशन जोडूया:
+
+```py
+import torch
+from transformers import AutoTokenizer, AutoModelForSequenceClassification
+
+checkpoint = "distilbert-base-uncased-finetuned-sst-2-english"
+tokenizer = AutoTokenizer.from_pretrained(checkpoint)
+model = AutoModelForSequenceClassification.from_pretrained(checkpoint)
+
+sequence = "I've been waiting for a HuggingFace course my whole life."
+
+tokens = tokenizer.tokenize(sequence)
+ids = tokenizer.convert_tokens_to_ids(tokens)
+
+input_ids = torch.tensor([ids])
+print("Input IDs:", input_ids)
+
+output = model(input_ids)
+print("Logits:", output.logits)
+```
+
+आपण इनपुट IDs तसेच परिणामी लॉजिट्स प्रिंट करतो — इथे आउटपुट आहे:
+
+```python out
+Input IDs: [[ 1045, 1005, 2310, 2042, 3403, 2005, 1037, 17662, 12172, 2607, 2026, 2878, 2166, 1012]]
+Logits: [[-2.7276, 2.8789]]
+```
+
+*बॅचिंग* म्हणजे एकाच वेळी मॉडेलद्वारे अनेक वाक्ये पाठवण्याची क्रिया. जर तुमच्याकडे फक्त एकच वाक्य असेल, तर तुम्ही फक्त एका सिक्वेन्ससह एक बॅच तयार करू शकता:
+
+```
+batched_ids = [ids, ids]
+```
+
+हा दोन समान सिक्वेन्सेसचा बॅच आहे!
+
+> [!TIP]
+> ✏️ **करून पहा!** या `batched_ids` यादीचे टेन्सरमध्ये रूपांतर करा आणि तुमच्या मॉडेलद्वारे पास करा. तुम्हाला आधीसारखेच लॉजिट्स मिळतात का ते तपासा (पण दोनदा)!
+
+बॅचिंगमुळे तुम्ही मॉडेलला अनेक वाक्ये दिली तरी ते काम करू शकते. एका सिक्वेन्ससह बॅच तयार करण्याइतकेच अनेक सिक्वेन्सेस वापरणे सोपे आहे. मात्र, इथे दुसरी एक समस्या आहे. जेव्हा तुम्ही दोन (किंवा अधिक) वाक्ये एकत्र बॅच करण्याचा प्रयत्न करता, तेव्हा त्यांची लांबी वेगवेगळी असू शकते. जर तुम्ही आधी कधी टेन्सर्ससोबत काम केले असेल, तर तुम्हाला माहीत असेल की ते आयताकृती आकाराचे असणे आवश्यक आहे, त्यामुळे तुम्ही इनपुट IDs ची यादी थेट टेन्सरमध्ये रूपांतरित करू शकणार नाही. या समस्येवर मात करण्यासाठी, आपण सहसा इनपुट्सना *पॅड* करतो.
+
+## इनपुट्सचे पॅडिंग[[padding-the-inputs]]
+
+खालील यादींची यादी टेन्सरमध्ये रूपांतरित करता येत नाही:
+
+```py no-format
+batched_ids = [
+ [200, 200, 200],
+ [200, 200]
+]
+```
+
+यावर मात करण्यासाठी, आपण आपल्या टेन्सर्सना आयताकृती आकार देण्यासाठी *पॅडिंग* वापरू. पॅडिंग हे सुनिश्चित करते की आपल्या सर्व वाक्यांची लांबी सारखी आहे, यासाठी कमी मूल्ये असलेल्या वाक्यांमध्ये *पॅडिंग टोकन* नावाचा एक विशेष शब्द जोडला जातो. उदाहरणार्थ, जर तुमच्याकडे 10 शब्द असलेली 10 वाक्ये आणि 20 शब्द असलेले 1 वाक्य असेल, तर पॅडिंग हे सुनिश्चित करेल की सर्व वाक्यांमध्ये 20 शब्द असतील. आपल्या उदाहरणात, परिणामी टेन्सर असे दिसते:
+
+```py no-format
+padding_id = 100
+
+batched_ids = [
+ [200, 200, 200],
+ [200, 200, padding_id],
+]
+```
+
+पॅडिंग टोकन ID `tokenizer.pad_token_id` मध्ये सापडू शकते. चला त्याचा वापर करूया आणि आपली दोन वाक्ये मॉडेलद्वारे स्वतंत्रपणे आणि एकत्र बॅच करून पाठवूया:
+
+```py no-format
+model = AutoModelForSequenceClassification.from_pretrained(checkpoint)
+
+sequence1_ids = [[200, 200, 200]]
+sequence2_ids = [[200, 200]]
+batched_ids = [
+ [200, 200, 200],
+ [200, 200, tokenizer.pad_token_id],
+]
+
+print(model(torch.tensor(sequence1_ids)).logits)
+print(model(torch.tensor(sequence2_ids)).logits)
+print(model(torch.tensor(batched_ids)).logits)
+```
+
+```python out
+tensor([[ 1.5694, -1.3895]], grad_fn=)
+tensor([[ 0.5803, -0.4125]], grad_fn=)
+tensor([[ 1.5694, -1.3895],
+ [ 1.3373, -1.2163]], grad_fn=)
+```
+
+आपल्या बॅच केलेल्या भाकितांमधील लॉजिट्समध्ये काहीतरी चूक आहे: दुसरी ओळ दुसऱ्या वाक्याच्या लॉजिट्ससारखीच असायला हवी होती, पण आपल्याला पूर्णपणे वेगळी मूल्ये मिळाली आहेत!
+
+याचे कारण असे की ट्रान्सफॉर्मर मॉडेल्सचे मुख्य वैशिष्ट्य म्हणजे अटेंशन लेयर्स जे प्रत्येक टोकनला *कॉन्टेक्स्च्युअलाइझ* करतात. हे पॅडिंग टोकन्सचा देखील विचार करतील कारण ते सिक्वेन्सच्या सर्व टोकन्सकडे लक्ष देतात. वेगवेगळ्या लांबीची स्वतंत्र वाक्ये मॉडेलद्वारे पाठवताना किंवा त्याच वाक्यांचा पॅडिंग लावलेला बॅच पाठवताना समान निकाल मिळवण्यासाठी, आपल्याला त्या अटेंशन लेयर्सना पॅडिंग टोकन्सकडे दुर्लक्ष करण्यास सांगावे लागते. हे अटेंशन मास्क वापरून केले जाते.
+
+## अटेंशन मास्क्स[[attention-masks]]
+
+*अटेंशन मास्क्स* हे इनपुट IDs टेन्सरसारख्याच आकाराचे टेन्सर्स असतात, जे 0 आणि 1 ने भरलेले असतात: 1 हे दर्शवते की संबंधित टोकन्सकडे लक्ष द्यायला हवे, आणि 0 हे दर्शवते की संबंधित टोकन्सकडे लक्ष द्यायला नको (म्हणजेच, मॉडेलच्या अटेंशन लेयर्सने त्यांच्याकडे दुर्लक्ष करायला हवे).
+
+चला मागील उदाहरण अटेंशन मास्कसह पूर्ण करूया:
+
+```py no-format
+batched_ids = [
+ [200, 200, 200],
+ [200, 200, tokenizer.pad_token_id],
+]
+
+attention_mask = [
+ [1, 1, 1],
+ [1, 1, 0],
+]
+
+outputs = model(torch.tensor(batched_ids), attention_mask=torch.tensor(attention_mask))
+print(outputs.logits)
+```
+
+```python out
+tensor([[ 1.5694, -1.3895],
+ [ 0.5803, -0.4125]], grad_fn=)
+```
+
+आता आपल्याला बॅचमधील दुसऱ्या वाक्यासाठी तेच लॉजिट्स मिळतात.
+
+लक्षात घ्या की दुसऱ्या सिक्वेन्सचे शेवटचे मूल्य एक पॅडिंग ID आहे, जे अटेंशन मास्कमध्ये 0 मूल्य आहे.
+
+> [!TIP]
+> ✏️ **करून पहा!** विभाग 2 मध्ये वापरलेल्या दोन वाक्यांवर ("I've been waiting for a HuggingFace course my whole life." आणि "I hate this so much!") स्वहस्ते टोकनायझेशन लागू करा. त्यांना मॉडेलद्वारे पाठवा आणि विभाग 2 मध्ये मिळालेले तेच लॉजिट्स तुम्हाला मिळतात का ते तपासा. आता पॅडिंग टोकन वापरून त्यांना एकत्र बॅच करा, नंतर योग्य अटेंशन मास्क तयार करा. मॉडेलद्वारे पाठवल्यावर तुम्हाला तेच निकाल मिळतात का ते तपासा!
+
+## लांब सिक्वेन्सेस[[longer-sequences]]
+
+ट्रान्सफॉर्मर मॉडेल्ससह, आपण मॉडेल्सना पाठवू शकणाऱ्या सिक्वेन्सेसच्या लांबीला एक मर्यादा असते. बहुतेक मॉडेल्स 512 किंवा 1024 टोकन्सपर्यंतच्या सिक्वेन्सेस हाताळतात, आणि त्याहून लांब सिक्वेन्सेस प्रक्रिया करण्यास सांगितल्यास ते क्रॅश होतील. या समस्येवर दोन उपाय आहेत:
+
+- लांब सपोर्टेड सिक्वेन्स लांबी असलेले मॉडेल वापरा.
+- तुमच्या सिक्वेन्सेसना ट्रंकेट करा.
+
+मॉडेल्सची सपोर्टेड सिक्वेन्स लांबी वेगवेगळी असते, आणि काही मॉडेल्स खूप लांब सिक्वेन्सेस हाताळण्यात विशेष असतात. [Longformer](https://huggingface.co/docs/transformers/model_doc/longformer) हे एक उदाहरण आहे, आणि दुसरे [LED](https://huggingface.co/docs/transformers/model_doc/led) आहे. जर तुम्ही खूप लांब सिक्वेन्सेसची आवश्यकता असलेल्या एखाद्या कामावर काम करत असाल, तर आम्ही तुम्हाला त्या मॉडेल्सकडे पाहण्याची शिफारस करतो.
+
+अन्यथा, आम्ही तुम्हाला `max_sequence_length` पॅरामीटर निर्दिष्ट करून तुमच्या सिक्वेन्सेसना ट्रंकेट करण्याची शिफारस करतो:
+
+```py
+sequence = sequence[:max_sequence_length]
+```
\ No newline at end of file
diff --git a/chapters/mr/chapter 2/6.mdx b/chapters/mr/chapter 2/6.mdx
new file mode 100644
index 000000000..705a70c3a
--- /dev/null
+++ b/chapters/mr/chapter 2/6.mdx
@@ -0,0 +1,133 @@
+
+
+# सर्वकाही एकत्र आणणे[[putting-it-all-together]]
+
+
+
+मागील काही विभागांमध्ये, आपण बहुतांश काम स्वहस्ते करण्याचा पुरेपूर प्रयत्न केला. आपण टोकनायझर्स कसे कार्य करतात याचा शोध घेतला आणि टोकनायझेशन, इनपुट IDs मध्ये रूपांतरण, पॅडिंग, ट्रंकेशन आणि अटेंशन मास्क्स पाहिले.
+
+मात्र, विभाग 2 मध्ये आपण पाहिल्याप्रमाणे, 🤗 Transformers API हे सर्व आपल्यासाठी एका उच्च-स्तरीय फंक्शनद्वारे हाताळू शकते, ज्यात आपण इथे सखोलपणे जाणार आहोत. जेव्हा तुम्ही तुमचा `tokenizer` थेट वाक्यावर कॉल करता, तेव्हा तुम्हाला असे इनपुट्स परत मिळतात जे तुमच्या मॉडेलमधून पाठवण्यासाठी तयार असतात:
+
+```py
+from transformers import AutoTokenizer
+
+checkpoint = "distilbert-base-uncased-finetuned-sst-2-english"
+tokenizer = AutoTokenizer.from_pretrained(checkpoint)
+
+sequence = "I've been waiting for a HuggingFace course my whole life."
+
+model_inputs = tokenizer(sequence)
+```
+
+इथे, `model_inputs` व्हेरिएबलमध्ये मॉडेलला व्यवस्थित काम करण्यासाठी आवश्यक असलेले सर्वकाही असते. DistilBERT साठी, त्यात इनपुट IDs तसेच अटेंशन मास्क समाविष्ट आहे. अतिरिक्त इनपुट्स स्वीकारणाऱ्या इतर मॉडेल्ससाठी देखील `tokenizer` ऑब्जेक्टद्वारे ते आउटपुट केले जातील.
+
+खाली दिलेल्या काही उदाहरणांमध्ये आपण पाहणार आहोत त्याप्रमाणे, ही पद्धत खूपच शक्तिशाली आहे. प्रथम, ती एकाच सिक्वेन्सला टोकनाइझ करू शकते:
+
+```py
+sequence = "I've been waiting for a HuggingFace course my whole life."
+
+model_inputs = tokenizer(sequence)
+```
+
+ती एकाच वेळी अनेक सिक्वेन्सेसदेखील हाताळते, API मध्ये कोणताही बदल न करता:
+
+```py
+sequences = ["I've been waiting for a HuggingFace course my whole life.", "So have I!"]
+
+model_inputs = tokenizer(sequences)
+```
+
+ती अनेक उद्दिष्टांनुसार पॅड करू शकते:
+
+```py
+# Will pad the sequences up to the maximum sequence length
+model_inputs = tokenizer(sequences, padding="longest")
+
+# Will pad the sequences up to the model max length
+# (512 for BERT or DistilBERT)
+model_inputs = tokenizer(sequences, padding="max_length")
+
+# Will pad the sequences up to the specified max length
+model_inputs = tokenizer(sequences, padding="max_length", max_length=8)
+```
+
+ती सिक्वेन्सेसना ट्रंकेटदेखील करू शकते:
+
+```py
+sequences = ["I've been waiting for a HuggingFace course my whole life.", "So have I!"]
+
+# Will truncate the sequences that are longer than the model max length
+# (512 for BERT or DistilBERT)
+model_inputs = tokenizer(sequences, truncation=True)
+
+# Will truncate the sequences that are longer than the specified max length
+model_inputs = tokenizer(sequences, max_length=8, truncation=True)
+```
+
+`tokenizer` ऑब्जेक्ट विशिष्ट फ्रेमवर्क टेन्सर्समध्ये रूपांतरण देखील हाताळू शकतो, जे नंतर थेट मॉडेलला पाठवता येतात. उदाहरणार्थ, खालील कोड नमुन्यात आपण टोकनायझरला वेगवेगळ्या फ्रेमवर्क्समधून टेन्सर्स परत करण्यास सांगत आहोत — `"pt"` PyTorch टेन्सर्स परत करतो आणि `"np"` NumPy अॅरे परत करतो:
+
+```py
+sequences = ["I've been waiting for a HuggingFace course my whole life.", "So have I!"]
+
+# Returns PyTorch tensors
+model_inputs = tokenizer(sequences, padding=True, return_tensors="pt")
+
+# Returns NumPy arrays
+model_inputs = tokenizer(sequences, padding=True, return_tensors="np")
+```
+
+## विशेष टोकन्स[[special-tokens]]
+
+जर आपण टोकनायझरने परत केलेल्या इनपुट IDs कडे पाहिले, तर आपल्याला दिसेल की ते आपल्याकडे आधी होते त्यापेक्षा थोडेसे वेगळे आहेत:
+
+```py
+sequence = "I've been waiting for a HuggingFace course my whole life."
+
+model_inputs = tokenizer(sequence)
+print(model_inputs["input_ids"])
+
+tokens = tokenizer.tokenize(sequence)
+ids = tokenizer.convert_tokens_to_ids(tokens)
+print(ids)
+```
+
+```python out
+[101, 1045, 1005, 2310, 2042, 3403, 2005, 1037, 17662, 12172, 2607, 2026, 2878, 2166, 1012, 102]
+[1045, 1005, 2310, 2042, 3403, 2005, 1037, 17662, 12172, 2607, 2026, 2878, 2166, 1012]
+```
+
+सुरुवातीला एक टोकन ID जोडली गेली आहे, आणि शेवटी एक. वरील दोन ID सिक्वेन्सेसना डीकोड करून हे काय आहे ते पाहूया:
+
+```py
+print(tokenizer.decode(model_inputs["input_ids"]))
+print(tokenizer.decode(ids))
+```
+
+```python out
+"[CLS] i've been waiting for a huggingface course my whole life. [SEP]"
+"i've been waiting for a huggingface course my whole life."
+```
+
+टोकनायझरने सुरुवातीला विशेष शब्द `[CLS]` आणि शेवटी विशेष शब्द `[SEP]` जोडला. याचे कारण असे की मॉडेल त्यांच्यासह पूर्व-प्रशिक्षित केले गेले होते, त्यामुळे इन्फरन्ससाठी तेच निकाल मिळवण्यासाठी आपल्यालाही ते जोडावे लागतात. लक्षात घ्या की काही मॉडेल्स विशेष शब्द जोडत नाहीत, किंवा वेगळे शब्द जोडतात; काही मॉडेल्स हे विशेष शब्द फक्त सुरुवातीला, किंवा फक्त शेवटी जोडू शकतात. कोणत्याही परिस्थितीत, टोकनायझरला कोणते अपेक्षित आहेत हे माहीत असते आणि तो हे तुमच्यासाठी हाताळेल.
+
+## सारांश: टोकनायझरपासून मॉडेलपर्यंत[[wrapping-up-from-tokenizer-to-model]]
+
+आता आपण मजकुरावर लागू केल्यावर `tokenizer` ऑब्जेक्ट वापरत असलेले सर्व स्वतंत्र टप्पे पाहिले आहेत, चला शेवटच्या वेळी पाहूया की तो त्याच्या मुख्य API सह अनेक सिक्वेन्सेस (पॅडिंग!), खूप लांब सिक्वेन्सेस (ट्रंकेशन!), आणि अनेक प्रकारचे टेन्सर्स कसे हाताळू शकतो:
+
+```py
+import torch
+from transformers import AutoTokenizer, AutoModelForSequenceClassification
+
+checkpoint = "distilbert-base-uncased-finetuned-sst-2-english"
+tokenizer = AutoTokenizer.from_pretrained(checkpoint)
+model = AutoModelForSequenceClassification.from_pretrained(checkpoint)
+sequences = ["I've been waiting for a HuggingFace course my whole life.", "So have I!"]
+
+tokens = tokenizer(sequences, padding=True, truncation=True, return_tensors="pt")
+output = model(**tokens)
+```
\ No newline at end of file
diff --git a/chapters/mr/chapter 2/7.mdx b/chapters/mr/chapter 2/7.mdx
new file mode 100644
index 000000000..ce7b62d34
--- /dev/null
+++ b/chapters/mr/chapter 2/7.mdx
@@ -0,0 +1,18 @@
+# मूलभूत वापर पूर्ण झाला![[basic-usage-completed]]
+
+
+
+इथपर्यंत कोर्स फॉलो केल्याबद्दल उत्तम काम! थोडक्यात आढावा घ्यायचा झाल्यास, या प्रकरणात तुम्ही:
+
+- ट्रान्सफॉर्मर मॉडेलच्या मूलभूत बिल्डिंग ब्लॉक्सबद्दल शिकलात.
+- टोकनायझेशन पाइपलाइन कशापासून बनते हे शिकलात.
+- प्रत्यक्षात ट्रान्सफॉर्मर मॉडेल कसे वापरायचे ते पाहिले.
+- मॉडेलला समजेल अशा टेन्सर्समध्ये मजकूराचे रूपांतर करण्यासाठी टोकनायझरचा वापर कसा करायचा हे शिकलात.
+- मजकुरापासून भाकितांपर्यंत पोहोचण्यासाठी टोकनायझर आणि मॉडेल एकत्र सेट अप केले.
+- इनपुट IDs च्या मर्यादा शिकलात, आणि अटेंशन मास्क्सबद्दल शिकलात.
+- बहुमुखी आणि कॉन्फिगर करण्यायोग्य टोकनायझर पद्धतींसह सराव केला.
+
+आतापासून, तुम्ही 🤗 Transformers डॉक्युमेंटेशनमध्ये मुक्तपणे संचार करू शकाल: शब्दावली परिचित वाटेल, आणि तुम्ही आधीच त्या पद्धती पाहिल्या आहेत ज्या तुम्ही बहुतांश वेळा वापराल.
\ No newline at end of file
diff --git a/chapters/mr/chapter 2/8.mdx b/chapters/mr/chapter 2/8.mdx
new file mode 100644
index 000000000..917cc1244
--- /dev/null
+++ b/chapters/mr/chapter 2/8.mdx
@@ -0,0 +1,857 @@
+# ऑप्टिमाइज्ड इन्फरन्स डिप्लॉयमेंट
+
+या विभागात, आपण LLM डिप्लॉयमेंट्सना ऑप्टिमाइझ करण्यासाठी प्रगत फ्रेमवर्क्सचा शोध घेणार आहोत: Text Generation Inference (TGI), vLLM, आणि llama.cpp. या अॅप्लिकेशन्सचा वापर प्रामुख्याने प्रोडक्शन एन्व्हायर्नमेंट्समध्ये वापरकर्त्यांना LLMs सर्व्ह करण्यासाठी केला जातो. हा विभाग या फ्रेमवर्क्सना एकाच मशीनवर इन्फरन्ससाठी कसे वापरायचे यापेक्षा प्रोडक्शनमध्ये कसे डिप्लॉय करायचे यावर लक्ष केंद्रित करतो.
+
+आपण या टूल्सद्वारे इन्फरन्स कार्यक्षमता कशी वाढवली जाते आणि लार्ज लँग्वेज मॉडेल्सचे प्रोडक्शन डिप्लॉयमेंट्स कसे सुलभ केले जातात याबद्दल जाणून घेऊ.
+
+## फ्रेमवर्क निवड मार्गदर्शक
+
+TGI, vLLM, आणि llama.cpp हे समान उद्देश पूर्ण करतात परंतु त्यांची वेगळी वैशिष्ट्ये आहेत जी त्यांना वेगवेगळ्या वापर प्रकरणांसाठी अधिक योग्य बनवतात. चला त्यांच्यातील मुख्य फरक पाहूया, कामगिरी आणि इंटिग्रेशनवर लक्ष केंद्रित करून.
+
+### मेमरी व्यवस्थापन आणि कामगिरी
+
+**TGI** प्रोडक्शनमध्ये स्थिर आणि अंदाज करण्यायोग्य असण्यासाठी डिझाइन केलेले आहे, मेमरी वापर सुसंगत ठेवण्यासाठी निश्चित सिक्वेन्स लांबी वापरते. TGI Flash Attention 2 आणि सतत बॅचिंग (continuous batching) तंत्रांचा वापर करून मेमरी व्यवस्थापित करते. याचा अर्थ ते अटेंशन गणना खूप कार्यक्षमतेने प्रक्रिया करू शकते आणि GPU ला सतत काम पुरवून व्यस्त ठेवू शकते. आवश्यकतेनुसार प्रणाली मॉडेलचे भाग CPU आणि GPU दरम्यान हलवू शकते, ज्यामुळे मोठ्या मॉडेल्सना हाताळण्यास मदत होते.
+
+
+
+
+
+Flash Attention हे एक तंत्र आहे जे मेमरी बँडविड्थ अडथळ्यांचे निराकरण करून ट्रान्सफॉर्मर मॉडेल्समधील अटेंशन यंत्रणा ऑप्टिमाइझ करते. आधी [प्रकरण 1.8](/course/chapter1/8) मध्ये चर्चा केल्याप्रमाणे, अटेंशन यंत्रणेची क्वाड्रॅटिक कॉम्प्लेक्सिटी आणि मेमरी वापर असतो, ज्यामुळे लांब सिक्वेन्सेससाठी ती अकार्यक्षम ठरते.
+
+मुख्य नावीन्य म्हणजे ते High Bandwidth Memory (HBM) आणि जलद SRAM कॅश दरम्यान मेमरी ट्रान्सफर्स कसे व्यवस्थापित करते यात आहे. पारंपरिक अटेंशन HBM आणि SRAM दरम्यान वारंवार डेटा ट्रान्सफर करते, ज्यामुळे GPU निष्क्रिय राहून अडथळे निर्माण होतात. Flash Attention डेटा एकदाच SRAM मध्ये लोड करते आणि सर्व गणना तिथेच करते, ज्यामुळे महागडे मेमरी ट्रान्सफर्स कमीत कमी होतात.
+
+प्रशिक्षणादरम्यान फायदे सर्वात लक्षणीय असले तरी, Flash Attention चा कमी झालेला VRAM वापर आणि सुधारित कार्यक्षमता इन्फरन्ससाठी देखील मौल्यवान ठरते, ज्यामुळे जलद आणि अधिक स्केलेबल LLM सर्व्हिंग शक्य होते.
+
+
+
+**vLLM** PagedAttention वापरून वेगळा दृष्टिकोन घेते. ज्याप्रमाणे संगणक त्याची मेमरी पेजेसमध्ये व्यवस्थापित करतो, त्याचप्रमाणे vLLM मॉडेलच्या मेमरीला लहान ब्लॉक्समध्ये विभागते. या हुशार प्रणालीमुळे ते वेगवेगळ्या आकाराच्या रिक्वेस्ट्सना अधिक लवचिकपणे हाताळू शकते आणि मेमरी स्पेस वाया घालवत नाही. वेगवेगळ्या रिक्वेस्ट्समध्ये मेमरी शेअर करण्यात हे विशेषतः चांगले आहे आणि मेमरी फ्रॅगमेंटेशन कमी करते, ज्यामुळे संपूर्ण प्रणाली अधिक कार्यक्षम बनते.
+
+
+
+PagedAttention हे एक तंत्र आहे जे LLM इन्फरन्समधील आणखी एका महत्त्वाच्या अडथळ्याचे निराकरण करते: KV कॅश मेमरी व्यवस्थापन. [प्रकरण 1.8](/course/chapter1/8) मध्ये चर्चा केल्याप्रमाणे, मजकूर निर्मितीदरम्यान, मॉडेल पुनरावृत्ती होणाऱ्या गणना कमी करण्यासाठी प्रत्येक तयार झालेल्या टोकनसाठी अटेंशन कीज आणि व्हॅल्यूज (KV कॅश) साठवते. विशेषतः लांब सिक्वेन्सेस किंवा अनेक समवर्ती रिक्वेस्ट्ससह KV कॅश प्रचंड मोठे होऊ शकते.
+
+vLLM चे मुख्य नावीन्य ते हा कॅश कसे व्यवस्थापित करते यात आहे:
+
+1. **मेमरी पेजिंग**: KV कॅशला एक मोठा ब्लॉक मानण्याऐवजी, त्याचे निश्चित आकाराच्या "पेजेस" मध्ये विभाजन केले जाते (ऑपरेटिंग सिस्टम्समधील व्हर्च्युअल मेमरीसारखे).
+2. **नॉन-कॉन्टिग्युअस स्टोरेज**: पेजेसना GPU मेमरीमध्ये सलग साठवण्याची गरज नसते, ज्यामुळे अधिक लवचिक मेमरी वाटप शक्य होते.
+3. **पेज टेबल व्यवस्थापन**: एक पेज टेबल कोणती पेजेस कोणत्या सिक्वेन्सशी संबंधित आहेत याचा मागोवा ठेवते, ज्यामुळे कार्यक्षम शोध आणि प्रवेश शक्य होतो.
+4. **मेमरी शेअरिंग**: पॅरलल सॅम्पलिंगसारख्या ऑपरेशन्ससाठी, प्रॉम्प्टचे KV कॅश साठवणारी पेजेस अनेक सिक्वेन्सेसमध्ये शेअर केली जाऊ शकतात.
+
+PagedAttention दृष्टिकोन पारंपरिक पद्धतींच्या तुलनेत 24 पट जास्त थ्रूपुटपर्यंत नेऊ शकतो, ज्यामुळे तो प्रोडक्शन LLM डिप्लॉयमेंट्ससाठी गेम-चेंजर ठरतो. PagedAttention कसे कार्य करते याबद्दल अधिक सखोलपणे जाणून घ्यायचे असल्यास, तुम्ही [vLLM डॉक्युमेंटेशनमधील मार्गदर्शक](https://docs.vllm.ai/en/latest/design/kernel/paged_attention.html) वाचू शकता.
+
+
+
+**llama.cpp** हे मूळतः कन्झ्युमर हार्डवेअरवर LLaMA मॉडेल्स चालवण्यासाठी डिझाइन केलेले अत्यंत ऑप्टिमाइझ केलेले C/C++ इम्प्लिमेंटेशन आहे. ते पर्यायी GPU प्रवेगासह CPU कार्यक्षमतेवर लक्ष केंद्रित करते आणि संसाधन-मर्यादित वातावरणांसाठी आदर्श आहे. llama.cpp चांगली कामगिरी राखत मॉडेलचा आकार आणि मेमरी आवश्यकता कमी करण्यासाठी क्वांटायझेशन तंत्रांचा वापर करते. ते वेगवेगळ्या CPU आर्किटेक्चर्ससाठी ऑप्टिमाइझ केलेले कर्नल्स इम्प्लिमेंट करते आणि कार्यक्षम टोकन जनरेशनसाठी मूलभूत KV कॅश व्यवस्थापन सपोर्ट करते.
+
+
+
+llama.cpp मधील क्वांटायझेशन मॉडेल वेट्सची अचूकता 32-बिट किंवा 16-बिट फ्लोटिंग पॉइंटवरून 8-बिट इंटिजर्स (INT8), 4-बिट, किंवा त्याहूनही कमी अचूकतेच्या फॉरमॅट्सपर्यंत कमी करते. यामुळे किमान गुणवत्ता हानीसह मेमरी वापर लक्षणीयरीत्या कमी होतो आणि इन्फरन्स गती सुधारते.
+
+llama.cpp मधील मुख्य क्वांटायझेशन वैशिष्ट्यांमध्ये समाविष्ट आहे:
+1. **अनेक क्वांटायझेशन लेव्हल्स**: 8-बिट, 4-बिट, 3-बिट, आणि अगदी 2-बिट क्वांटायझेशन सपोर्ट करते
+2. **GGML/GGUF फॉरमॅट**: क्वांटाइज्ड इन्फरन्ससाठी ऑप्टिमाइझ केलेले कस्टम टेन्सर फॉरमॅट्स वापरते
+3. **मिश्र अचूकता**: मॉडेलच्या वेगवेगळ्या भागांना वेगवेगळे क्वांटायझेशन लेव्हल्स लागू करू शकते
+4. **हार्डवेअर-विशिष्ट ऑप्टिमायझेशन्स**: वेगवेगळ्या CPU आर्किटेक्चर्ससाठी (AVX2, AVX-512, NEON) ऑप्टिमाइझ केलेले कोड पाथ्स समाविष्ट करते
+
+हा दृष्टिकोन मर्यादित मेमरी असलेल्या कन्झ्युमर हार्डवेअरवर अब्जावधी-पॅरामीटर मॉडेल्स चालवणे शक्य करतो, ज्यामुळे तो स्थानिक डिप्लॉयमेंट्स आणि एज डिव्हाइसेससाठी परिपूर्ण ठरतो.
+
+
+
+### डिप्लॉयमेंट आणि इंटिग्रेशन
+
+चला फ्रेमवर्क्समधील डिप्लॉयमेंट आणि इंटिग्रेशन फरकांकडे वळूया.
+
+**TGI** त्याच्या प्रोडक्शन-रेडी वैशिष्ट्यांसह एंटरप्राइझ-स्तरीय डिप्लॉयमेंटमध्ये उत्कृष्ट आहे. ते Kubernetes साठी अंगभूत सपोर्टसह येते आणि प्रोडक्शनमध्ये चालवण्यासाठी आवश्यक असलेले सर्वकाही समाविष्ट करते, जसे की Prometheus आणि Grafana द्वारे मॉनिटरिंग, स्वयंचलित स्केलिंग, आणि सर्वसमावेशक सुरक्षा वैशिष्ट्ये. प्रणालीमध्ये एंटरप्राइझ-दर्जाचे लॉगिंग आणि तुमचे डिप्लॉयमेंट सुरक्षित आणि स्थिर ठेवण्यासाठी कंटेंट फिल्टरिंग आणि रेट लिमिटिंग सारखे विविध संरक्षणात्मक उपाय देखील समाविष्ट आहेत.
+
+**vLLM** डिप्लॉयमेंटसाठी अधिक लवचिक, डेव्हलपर-अनुकूल दृष्टिकोन घेते. ते Python च्या गाभ्यासह तयार केले गेले आहे आणि तुमच्या विद्यमान अॅप्लिकेशन्समध्ये OpenAI च्या API ला सहजपणे बदलू शकते. फ्रेमवर्क कच्च्या कामगिरीवर लक्ष केंद्रित करते आणि तुमच्या विशिष्ट गरजांनुसार कस्टमाइझ केले जाऊ शकते. क्लस्टर व्यवस्थापित करण्यासाठी हे Ray सोबत विशेषतः चांगले काम करते, ज्यामुळे तुम्हाला उच्च कामगिरी आणि अनुकूलतेची गरज असताना हा एक उत्तम पर्याय ठरतो.
+
+**llama.cpp** साधेपणा आणि पोर्टेबिलिटीला प्राधान्य देते. त्याची सर्व्हर इम्प्लिमेंटेशन हलकी आहे आणि शक्तिशाली सर्व्हर्सपासून ते कन्झ्युमर लॅपटॉप्स आणि काही उच्च-दर्जाच्या मोबाइल डिव्हाइसेसपर्यंत विविध हार्डवेअरवर चालू शकते. किमान अवलंबित्व आणि साधा C/C++ कोर असल्यामुळे, Python फ्रेमवर्क्स इन्स्टॉल करणे आव्हानात्मक असलेल्या वातावरणांमध्ये देखील ते सहजपणे डिप्लॉय करता येते. सर्व्हर इतर सोल्युशन्सपेक्षा खूपच लहान रिसोर्स फूटप्रिंट राखत OpenAI-सुसंगत API पुरवते.
+
+## सुरुवात करणे
+
+चला LLMs डिप्लॉय करण्यासाठी हे फ्रेमवर्क्स कसे वापरायचे ते पाहूया, इन्स्टॉलेशन आणि मूलभूत सेटअपपासून सुरुवात करून.
+
+### इन्स्टॉलेशन आणि मूलभूत सेटअप
+
+
+
+
+
+TGI इन्स्टॉल करणे आणि वापरणे सोपे आहे, Hugging Face इकोसिस्टमसह सखोल इंटिग्रेशनसह.
+
+प्रथम, Docker वापरून TGI सर्व्हर लाँच करा:
+
+```sh
+docker run --gpus all \
+ --shm-size 1g \
+ -p 8080:80 \
+ -v ~/.cache/huggingface:/data \
+ ghcr.io/huggingface/text-generation-inference:latest \
+ --model-id HuggingFaceTB/SmolLM2-360M-Instruct
+```
+
+नंतर Hugging Face च्या InferenceClient चा वापर करून त्याच्याशी संवाद साधा:
+
+```python
+from huggingface_hub import InferenceClient
+
+# Initialize client pointing to TGI endpoint
+client = InferenceClient(
+ model="http://localhost:8080", # URL to the TGI server
+)
+
+# Text generation
+response = client.text_generation(
+ "Tell me a story",
+ max_new_tokens=100,
+ temperature=0.7,
+ top_p=0.95,
+ details=True,
+ stop_sequences=[],
+)
+print(response.generated_text)
+
+# For chat format
+response = client.chat_completion(
+ messages=[
+ {"role": "system", "content": "You are a helpful assistant."},
+ {"role": "user", "content": "Tell me a story"},
+ ],
+ max_tokens=100,
+ temperature=0.7,
+ top_p=0.95,
+)
+print(response.choices[0].message.content)
+```
+
+पर्यायाने, तुम्ही OpenAI क्लायंट वापरू शकता:
+
+```python
+from openai import OpenAI
+
+# Initialize client pointing to TGI endpoint
+client = OpenAI(
+ base_url="http://localhost:8080/v1", # Make sure to include /v1
+ api_key="not-needed", # TGI doesn't require an API key by default
+)
+
+# Chat completion
+response = client.chat.completions.create(
+ model="HuggingFaceTB/SmolLM2-360M-Instruct",
+ messages=[
+ {"role": "system", "content": "You are a helpful assistant."},
+ {"role": "user", "content": "Tell me a story"},
+ ],
+ max_tokens=100,
+ temperature=0.7,
+ top_p=0.95,
+)
+print(response.choices[0].message.content)
+```
+
+
+
+
+
+llama.cpp इन्स्टॉल करणे आणि वापरणे सोपे आहे, किमान अवलंबित्वाची आवश्यकता असते आणि CPU व GPU दोन्ही इन्फरन्स सपोर्ट करते.
+
+प्रथम, llama.cpp इन्स्टॉल आणि बिल्ड करा:
+
+```sh
+# Clone the repository
+git clone https://github.com/ggerganov/llama.cpp
+cd llama.cpp
+
+# Build the project
+make
+
+# Download the SmolLM2-1.7B-Instruct-GGUF model
+curl -L -O https://huggingface.co/HuggingFaceTB/SmolLM2-1.7B-Instruct-GGUF/resolve/main/smollm2-1.7b-instruct.Q4_K_M.gguf
+```
+
+नंतर, सर्व्हर लाँच करा (OpenAI API सुसंगततेसह):
+
+```sh
+# Start the server
+./server \
+ -m smollm2-1.7b-instruct.Q4_K_M.gguf \
+ --host 0.0.0.0 \
+ --port 8080 \
+ -c 4096 \
+ --n-gpu-layers 0 # Set to a higher number to use GPU
+```
+
+Hugging Face च्या InferenceClient चा वापर करून सर्व्हरशी संवाद साधा:
+
+```python
+from huggingface_hub import InferenceClient
+
+# Initialize client pointing to llama.cpp server
+client = InferenceClient(
+ model="http://localhost:8080/v1", # URL to the llama.cpp server
+ token="sk-no-key-required", # llama.cpp server requires this placeholder
+)
+
+# Text generation
+response = client.text_generation(
+ "Tell me a story",
+ max_new_tokens=100,
+ temperature=0.7,
+ top_p=0.95,
+ details=True,
+)
+print(response.generated_text)
+
+# For chat format
+response = client.chat_completion(
+ messages=[
+ {"role": "system", "content": "You are a helpful assistant."},
+ {"role": "user", "content": "Tell me a story"},
+ ],
+ max_tokens=100,
+ temperature=0.7,
+ top_p=0.95,
+)
+print(response.choices[0].message.content)
+```
+
+पर्यायाने, तुम्ही OpenAI क्लायंट वापरू शकता:
+
+```python
+from openai import OpenAI
+
+# Initialize client pointing to llama.cpp server
+client = OpenAI(
+ base_url="http://localhost:8080/v1",
+ api_key="sk-no-key-required", # llama.cpp server requires this placeholder
+)
+
+# Chat completion
+response = client.chat.completions.create(
+ model="smollm2-1.7b-instruct", # Model identifier can be anything as server only loads one model
+ messages=[
+ {"role": "system", "content": "You are a helpful assistant."},
+ {"role": "user", "content": "Tell me a story"},
+ ],
+ max_tokens=100,
+ temperature=0.7,
+ top_p=0.95,
+)
+print(response.choices[0].message.content)
+```
+
+
+
+
+
+vLLM इन्स्टॉल करणे आणि वापरणे सोपे आहे, OpenAI API सुसंगतता आणि नेटिव्ह Python इंटरफेस दोन्हीसह.
+
+प्रथम, vLLM OpenAI-सुसंगत सर्व्हर लाँच करा:
+
+```sh
+python -m vllm.entrypoints.openai.api_server \
+ --model HuggingFaceTB/SmolLM2-360M-Instruct \
+ --host 0.0.0.0 \
+ --port 8000
+```
+
+नंतर Hugging Face च्या InferenceClient चा वापर करून त्याच्याशी संवाद साधा:
+
+```python
+from huggingface_hub import InferenceClient
+
+# Initialize client pointing to vLLM endpoint
+client = InferenceClient(
+ model="http://localhost:8000/v1", # URL to the vLLM server
+)
+
+# Text generation
+response = client.text_generation(
+ "Tell me a story",
+ max_new_tokens=100,
+ temperature=0.7,
+ top_p=0.95,
+ details=True,
+)
+print(response.generated_text)
+
+# For chat format
+response = client.chat_completion(
+ messages=[
+ {"role": "system", "content": "You are a helpful assistant."},
+ {"role": "user", "content": "Tell me a story"},
+ ],
+ max_tokens=100,
+ temperature=0.7,
+ top_p=0.95,
+)
+print(response.choices[0].message.content)
+```
+
+पर्यायाने, तुम्ही OpenAI क्लायंट वापरू शकता:
+
+```python
+from openai import OpenAI
+
+# Initialize client pointing to vLLM endpoint
+client = OpenAI(
+ base_url="http://localhost:8000/v1",
+ api_key="not-needed", # vLLM doesn't require an API key by default
+)
+
+# Chat completion
+response = client.chat.completions.create(
+ model="HuggingFaceTB/SmolLM2-360M-Instruct",
+ messages=[
+ {"role": "system", "content": "You are a helpful assistant."},
+ {"role": "user", "content": "Tell me a story"},
+ ],
+ max_tokens=100,
+ temperature=0.7,
+ top_p=0.95,
+)
+print(response.choices[0].message.content)
+```
+
+
+
+
+
+### मूलभूत मजकूर निर्मिती
+
+चला फ्रेमवर्क्ससह मजकूर निर्मितीची उदाहरणे पाहूया:
+
+
+
+
+
+प्रथम, प्रगत पॅरामीटर्ससह TGI डिप्लॉय करा:
+```sh
+docker run --gpus all \
+ --shm-size 1g \
+ -p 8080:80 \
+ -v ~/.cache/huggingface:/data \
+ ghcr.io/huggingface/text-generation-inference:latest \
+ --model-id HuggingFaceTB/SmolLM2-360M-Instruct \
+ --max-total-tokens 4096 \
+ --max-input-length 3072 \
+ --max-batch-total-tokens 8192 \
+ --waiting-served-ratio 1.2
+```
+
+लवचिक मजकूर निर्मितीसाठी InferenceClient वापरा:
+
+```python
+from huggingface_hub import InferenceClient
+
+client = InferenceClient(model="http://localhost:8080")
+
+# Advanced parameters example
+response = client.chat_completion(
+ messages=[
+ {"role": "system", "content": "You are a creative storyteller."},
+ {"role": "user", "content": "Write a creative story"},
+ ],
+ temperature=0.8,
+ max_tokens=200,
+ top_p=0.95,
+)
+print(response.choices[0].message.content)
+
+# Raw text generation
+response = client.text_generation(
+ "Write a creative story about space exploration",
+ max_new_tokens=200,
+ temperature=0.8,
+ top_p=0.95,
+ repetition_penalty=1.1,
+ do_sample=True,
+ details=True,
+)
+print(response.generated_text)
+```
+
+किंवा OpenAI क्लायंट वापरा:
+```python
+from openai import OpenAI
+
+client = OpenAI(base_url="http://localhost:8080/v1", api_key="not-needed")
+
+# Advanced parameters example
+response = client.chat.completions.create(
+ model="HuggingFaceTB/SmolLM2-360M-Instruct",
+ messages=[
+ {"role": "system", "content": "You are a creative storyteller."},
+ {"role": "user", "content": "Write a creative story"},
+ ],
+ temperature=0.8, # Higher for more creativity
+)
+print(response.choices[0].message.content)
+```
+
+
+
+
+
+llama.cpp साठी, तुम्ही सर्व्हर लाँच करताना प्रगत पॅरामीटर्स सेट करू शकता:
+
+```sh
+./server \
+ -m smollm2-1.7b-instruct.Q4_K_M.gguf \
+ --host 0.0.0.0 \
+ --port 8080 \
+ -c 4096 \ # Context size
+ --threads 8 \ # CPU threads to use
+ --batch-size 512 \ # Batch size for prompt evaluation
+ --n-gpu-layers 0 # GPU layers (0 = CPU only)
+```
+
+InferenceClient वापरा:
+
+```python
+from huggingface_hub import InferenceClient
+
+client = InferenceClient(model="http://localhost:8080/v1", token="sk-no-key-required")
+
+# Advanced parameters example
+response = client.chat_completion(
+ messages=[
+ {"role": "system", "content": "You are a creative storyteller."},
+ {"role": "user", "content": "Write a creative story"},
+ ],
+ temperature=0.8,
+ max_tokens=200,
+ top_p=0.95,
+)
+print(response.choices[0].message.content)
+
+# For direct text generation
+response = client.text_generation(
+ "Write a creative story about space exploration",
+ max_new_tokens=200,
+ temperature=0.8,
+ top_p=0.95,
+ repetition_penalty=1.1,
+ details=True,
+)
+print(response.generated_text)
+```
+
+किंवा सॅम्पलिंग पॅरामीटर्सवर नियंत्रणासह जनरेशनसाठी OpenAI क्लायंट वापरा:
+
+```python
+from openai import OpenAI
+
+client = OpenAI(base_url="http://localhost:8080/v1", api_key="sk-no-key-required")
+
+# Advanced parameters example
+response = client.chat.completions.create(
+ model="smollm2-1.7b-instruct",
+ messages=[
+ {"role": "system", "content": "You are a creative storyteller."},
+ {"role": "user", "content": "Write a creative story"},
+ ],
+ temperature=0.8, # Higher for more creativity
+ top_p=0.95, # Nucleus sampling probability
+ frequency_penalty=0.5, # Reduce repetition of frequent tokens
+ presence_penalty=0.5, # Reduce repetition by penalizing tokens already present
+ max_tokens=200, # Maximum generation length
+)
+print(response.choices[0].message.content)
+```
+
+तुम्ही आणखी अधिक नियंत्रणासाठी llama.cpp ची नेटिव्ह लायब्ररी देखील वापरू शकता:
+
+```python
+# Using llama-cpp-python package for direct model access
+from llama_cpp import Llama
+
+# Load the model
+llm = Llama(
+ model_path="smollm2-1.7b-instruct.Q4_K_M.gguf",
+ n_ctx=4096, # Context window size
+ n_threads=8, # CPU threads
+ n_gpu_layers=0, # GPU layers (0 = CPU only)
+)
+
+# Format prompt according to the model's expected format
+prompt = """<|im_start|>system
+You are a creative storyteller.
+<|im_end|>
+<|im_start|>user
+Write a creative story
+<|im_end|>
+<|im_start|>assistant
+"""
+
+# Generate response with precise parameter control
+output = llm(
+ prompt,
+ max_tokens=200,
+ temperature=0.8,
+ top_p=0.95,
+ frequency_penalty=0.5,
+ presence_penalty=0.5,
+ stop=["<|im_end|>"],
+)
+
+print(output["choices"][0]["text"])
+```
+
+
+
+
+
+vLLM सह प्रगत वापरासाठी, तुम्ही InferenceClient वापरू शकता:
+
+```python
+from huggingface_hub import InferenceClient
+
+client = InferenceClient(model="http://localhost:8000/v1")
+
+# Advanced parameters example
+response = client.chat_completion(
+ messages=[
+ {"role": "system", "content": "You are a creative storyteller."},
+ {"role": "user", "content": "Write a creative story"},
+ ],
+ temperature=0.8,
+ max_tokens=200,
+ top_p=0.95,
+)
+print(response.choices[0].message.content)
+
+# For direct text generation
+response = client.text_generation(
+ "Write a creative story about space exploration",
+ max_new_tokens=200,
+ temperature=0.8,
+ top_p=0.95,
+ details=True,
+)
+print(response.generated_text)
+```
+
+तुम्ही OpenAI क्लायंट देखील वापरू शकता:
+
+```python
+from openai import OpenAI
+
+client = OpenAI(base_url="http://localhost:8000/v1", api_key="not-needed")
+
+# Advanced parameters example
+response = client.chat.completions.create(
+ model="HuggingFaceTB/SmolLM2-360M-Instruct",
+ messages=[
+ {"role": "system", "content": "You are a creative storyteller."},
+ {"role": "user", "content": "Write a creative story"},
+ ],
+ temperature=0.8,
+ top_p=0.95,
+ max_tokens=200,
+)
+print(response.choices[0].message.content)
+```
+
+vLLM बारकाईने नियंत्रणासह एक नेटिव्ह Python इंटरफेस देखील पुरवते:
+
+```python
+from vllm import LLM, SamplingParams
+
+# Initialize the model with advanced parameters
+llm = LLM(
+ model="HuggingFaceTB/SmolLM2-360M-Instruct",
+ gpu_memory_utilization=0.85,
+ max_num_batched_tokens=8192,
+ max_num_seqs=256,
+ block_size=16,
+)
+
+# Configure sampling parameters
+sampling_params = SamplingParams(
+ temperature=0.8, # Higher for more creativity
+ top_p=0.95, # Consider top 95% probability mass
+ max_tokens=100, # Maximum length
+ presence_penalty=1.1, # Reduce repetition
+ frequency_penalty=1.1, # Reduce repetition
+ stop=["\n\n", "###"], # Stop sequences
+)
+
+# Generate text
+prompt = "Write a creative story"
+outputs = llm.generate(prompt, sampling_params)
+print(outputs[0].outputs[0].text)
+
+# For chat-style interactions
+chat_prompt = [
+ {"role": "system", "content": "You are a creative storyteller."},
+ {"role": "user", "content": "Write a creative story"},
+]
+formatted_prompt = llm.get_chat_template()(chat_prompt) # Uses model's chat template
+outputs = llm.generate(formatted_prompt, sampling_params)
+print(outputs[0].outputs[0].text)
+```
+
+
+
+
+
+## प्रगत जनरेशन नियंत्रण
+
+### टोकन निवड आणि सॅम्पलिंग
+
+मजकूर निर्मितीच्या प्रक्रियेत प्रत्येक टप्प्यावर पुढील टोकन निवडणे समाविष्ट असते. या निवड प्रक्रियेला विविध पॅरामीटर्सद्वारे नियंत्रित केले जाऊ शकते:
+
+1. **कच्चे लॉजिट्स (Raw Logits)**: प्रत्येक टोकनसाठी प्रारंभिक आउटपुट संभाव्यता
+2. **तापमान (Temperature)**: निवडीतील यादृच्छिकता नियंत्रित करते (जास्त = अधिक सर्जनशील)
+3. **टॉप-p (Nucleus) सॅम्पलिंग**: संभाव्यतेच्या X% भाग बनवणाऱ्या टॉप टोकन्सपर्यंत फिल्टर करते
+4. **टॉप-k फिल्टरिंग**: निवड सर्वात संभाव्य k टोकन्सपुरती मर्यादित करते
+
+हे पॅरामीटर्स कसे कॉन्फिगर करायचे ते इथे आहे:
+
+
+
+
+
+```python
+client.generate(
+ "Write a creative story",
+ temperature=0.8, # Higher for more creativity
+ top_p=0.95, # Consider top 95% probability mass
+ top_k=50, # Consider top 50 tokens
+ max_new_tokens=100, # Maximum length
+ repetition_penalty=1.1, # Reduce repetition
+)
+```
+
+
+
+
+
+```python
+# Via OpenAI API compatibility
+response = client.completions.create(
+ model="smollm2-1.7b-instruct", # Model name (can be any string for llama.cpp server)
+ prompt="Write a creative story",
+ temperature=0.8, # Higher for more creativity
+ top_p=0.95, # Consider top 95% probability mass
+ frequency_penalty=1.1, # Reduce repetition
+ presence_penalty=0.1, # Reduce repetition
+ max_tokens=100, # Maximum length
+)
+
+# Via llama-cpp-python direct access
+output = llm(
+ "Write a creative story",
+ temperature=0.8,
+ top_p=0.95,
+ top_k=50,
+ max_tokens=100,
+ repeat_penalty=1.1,
+)
+```
+
+
+
+
+
+```python
+params = SamplingParams(
+ temperature=0.8, # Higher for more creativity
+ top_p=0.95, # Consider top 95% probability mass
+ top_k=50, # Consider top 50 tokens
+ max_tokens=100, # Maximum length
+ presence_penalty=0.1, # Reduce repetition
+)
+llm.generate("Write a creative story", sampling_params=params)
+```
+
+
+
+
+
+### पुनरावृत्ती नियंत्रित करणे
+
+दोन्ही फ्रेमवर्क्स पुनरावृत्ती होणारी मजकूर निर्मिती रोखण्याचे मार्ग पुरवतात:
+
+
+
+
+
+```python
+client.generate(
+ "Write a varied text",
+ repetition_penalty=1.1, # Penalize repeated tokens
+ no_repeat_ngram_size=3, # Prevent 3-gram repetition
+)
+```
+
+
+
+
+
+```python
+# Via OpenAI API
+response = client.completions.create(
+ model="smollm2-1.7b-instruct",
+ prompt="Write a varied text",
+ frequency_penalty=1.1, # Penalize frequent tokens
+ presence_penalty=0.8, # Penalize tokens already present
+)
+
+# Via direct library
+output = llm(
+ "Write a varied text",
+ repeat_penalty=1.1, # Penalize repeated tokens
+ frequency_penalty=0.5, # Additional frequency penalty
+ presence_penalty=0.5, # Additional presence penalty
+)
+```
+
+
+
+
+
+```python
+params = SamplingParams(
+ presence_penalty=0.1, # Penalize token presence
+ frequency_penalty=0.1, # Penalize token frequency
+)
+```
+
+
+
+
+
+### लांबी नियंत्रण आणि स्टॉप सिक्वेन्सेस
+
+तुम्ही जनरेशनची लांबी नियंत्रित करू शकता आणि ते केव्हा थांबवायचे हे निर्दिष्ट करू शकता:
+
+
+
+
+
+```python
+client.generate(
+ "Generate a short paragraph",
+ max_new_tokens=100,
+ min_new_tokens=10,
+ stop_sequences=["\n\n", "###"],
+)
+```
+
+
+
+
+
+```python
+# Via OpenAI API
+response = client.completions.create(
+ model="smollm2-1.7b-instruct",
+ prompt="Generate a short paragraph",
+ max_tokens=100,
+ stop=["\n\n", "###"],
+)
+
+# Via direct library
+output = llm("Generate a short paragraph", max_tokens=100, stop=["\n\n", "###"])
+```
+
+
+
+
+
+```python
+params = SamplingParams(
+ max_tokens=100,
+ min_tokens=10,
+ stop=["###", "\n\n"],
+ ignore_eos=False,
+ skip_special_tokens=True,
+)
+```
+
+
+
+
+
+## मेमरी व्यवस्थापन
+
+कार्यक्षम इन्फरन्ससाठी दोन्ही फ्रेमवर्क्स प्रगत मेमरी व्यवस्थापन तंत्रे इम्प्लिमेंट करतात.
+
+
+
+
+
+TGI Flash Attention 2 आणि सतत बॅचिंग वापरते:
+
+```sh
+# Docker deployment with memory optimization
+docker run --gpus all -p 8080:80 \
+ --shm-size 1g \
+ ghcr.io/huggingface/text-generation-inference:latest \
+ --model-id HuggingFaceTB/SmolLM2-1.7B-Instruct \
+ --max-batch-total-tokens 8192 \
+ --max-input-length 4096
+```
+
+
+
+
+
+llama.cpp क्वांटायझेशन आणि ऑप्टिमाइझ केलेला मेमरी लेआउट वापरते:
+
+```sh
+# Server with memory optimizations
+./server \
+ -m smollm2-1.7b-instruct.Q4_K_M.gguf \
+ --host 0.0.0.0 \
+ --port 8080 \
+ -c 2048 \ # Context size
+ --threads 4 \ # CPU threads
+ --n-gpu-layers 32 \ # Use more GPU layers for larger models
+ --mlock \ # Lock memory to prevent swapping
+ --cont-batching # Enable continuous batching
+```
+
+तुमच्या GPU साठी खूप मोठ्या असलेल्या मॉडेल्ससाठी, तुम्ही CPU ऑफलोडिंग वापरू शकता:
+
+```sh
+./server \
+ -m smollm2-1.7b-instruct.Q4_K_M.gguf \
+ --n-gpu-layers 20 \ # Keep first 20 layers on GPU
+ --threads 8 # Use more CPU threads for CPU layers
+```
+
+
+
+
+
+vLLM उत्कृष्ट मेमरी व्यवस्थापनासाठी PagedAttention वापरते:
+
+```python
+from vllm.engine.arg_utils import AsyncEngineArgs
+
+engine_args = AsyncEngineArgs(
+ model="HuggingFaceTB/SmolLM2-1.7B-Instruct",
+ gpu_memory_utilization=0.85,
+ max_num_batched_tokens=8192,
+ block_size=16,
+)
+
+llm = LLM(engine_args=engine_args)
+```
+
+
+
+
+
+## संसाधने
+
+- [Text Generation Inference डॉक्युमेंटेशन](https://huggingface.co/docs/text-generation-inference)
+- [TGI GitHub रिपॉझिटरी](https://github.com/huggingface/text-generation-inference)
+- [vLLM डॉक्युमेंटेशन](https://vllm.readthedocs.io/)
+- [vLLM GitHub रिपॉझिटरी](https://github.com/vllm-project/vllm)
+- [PagedAttention पेपर](https://arxiv.org/abs/2309.06180)
+- [llama.cpp GitHub रिपॉझिटरी](https://github.com/ggerganov/llama.cpp)
+- [llama-cpp-python रिपॉझिटरी](https://github.com/abetlen/llama-cpp-python)
\ No newline at end of file
diff --git a/chapters/mr/chapter 2/9.mdx b/chapters/mr/chapter 2/9.mdx
new file mode 100644
index 000000000..00084a24e
--- /dev/null
+++ b/chapters/mr/chapter 2/9.mdx
@@ -0,0 +1,252 @@
+
+
+
+
+# प्रकरणाच्या शेवटी क्विझ[[end-of-chapter-quiz]]
+
+
+
+### 1. लँग्वेज मॉडेलिंग पाइपलाइनचा क्रम काय आहे?
+
+
+
+### 2. बेस ट्रान्सफॉर्मर मॉडेलद्वारे आउटपुट केलेल्या टेन्सरला किती डायमेंशन्स असतात, आणि ते कोणते आहेत?
+
+
+
+### 3. खालीलपैकी कोणते सबवर्ड टोकनायझेशनचे उदाहरण आहे?
+
+
+
+### 4. मॉडेल हेड म्हणजे काय?
+
+
+
+### 5. AutoModel म्हणजे काय?
+
+AutoTrain प्रॉडक्टशी गोंधळत आहात का?"
+ },
+ {
+ text: "एक ऑब्जेक्ट जो चेकपॉइंटच्या आधारे योग्य आर्किटेक्चर परत करतो",
+ explain: "बरोबर: AutoModel ला योग्य आर्किटेक्चर परत करण्यासाठी फक्त कोणत्या चेकपॉइंटवरून इन्स्टंशिएट करायचे हे माहीत असणे आवश्यक आहे.",
+ correct: true
+ },
+ {
+ text: "असे मॉडेल जे योग्य वेट्स लोड करण्यासाठी त्याच्या इनपुट्ससाठी वापरलेली भाषा स्वयंचलितपणे शोधते",
+ explain: "काही चेकपॉइंट्स आणि मॉडेल्स अनेक भाषा हाताळण्यास सक्षम असले तरी, भाषेनुसार स्वयंचलित चेकपॉइंट निवडीसाठी कोणतीही अंगभूत टूल्स नाहीत. तुमच्या कामासाठी सर्वोत्तम चेकपॉइंट शोधण्यासाठी तुम्ही Model Hub कडे जावे!"
+ }
+ ]}
+/>
+
+### 6. वेगवेगळ्या लांबीच्या सिक्वेन्सेसना एकत्र बॅच करताना कोणत्या तंत्रांबद्दल जागरूक असणे आवश्यक आहे?
+
+
+
+### 7. सिक्वेन्स क्लासिफिकेशन मॉडेलद्वारे आउटपुट केलेल्या लॉजिट्सवर SoftMax फंक्शन लागू करण्याचा उद्देश काय आहे?
+
+
+
+### 8. बहुतांश टोकनायझर API कोणत्या पद्धतीभोवती केंद्रित आहे?
+
+encode, कारण ती मजकुराला IDs मध्ये आणि IDs ला भाकितांमध्ये एन्कोड करू शकते",
+ explain: "चूक! टोकनायझर्सवर encode पद्धत अस्तित्वात असली तरी, ती मॉडेल्सवर अस्तित्वात नाही."
+ },
+ {
+ text: "टोकनायझर ऑब्जेक्टला थेट कॉल करणे.",
+ explain: "अगदी बरोबर! टोकनायझरची __call__ पद्धत एक अत्यंत शक्तिशाली पद्धत आहे जी जवळजवळ कोणतीही गोष्ट हाताळू शकते. मॉडेलकडून भाकिते मिळवण्यासाठी वापरली जाणारी हीच पद्धत आहे.",
+ correct: true
+ },
+ {
+ text: "pad",
+ explain: "चूक! पॅडिंग खूप उपयुक्त आहे, पण तो टोकनायझर API चा फक्त एकच भाग आहे."
+ },
+ {
+ text: "tokenize",
+ explain: "tokenize पद्धत ही निश्चितपणे सर्वात उपयुक्त पद्धतींपैकी एक आहे, पण ती टोकनायझर API चा गाभा नाही."
+ }
+ ]}
+/>
+
+### 9. या कोड नमुन्यात `result` व्हेरिएबलमध्ये काय समाविष्ट आहे?
+
+```py
+from transformers import AutoTokenizer
+
+tokenizer = AutoTokenizer.from_pretrained("bert-base-cased")
+result = tokenizer.tokenize("Hello!")
+```
+
+__call__ किंवा convert_tokens_to_ids पद्धत आहे!"
+ },
+ {
+ text: "सर्व टोकन्स असलेली एक स्ट्रिंग",
+ explain: "हे सर्वोत्तम नसेल, कारण उद्दिष्ट स्ट्रिंगचे अनेक टोकन्समध्ये विभाजन करणे हे आहे."
+ }
+ ]}
+/>
+
+### 10. खालील कोडमध्ये काही चुकीचे आहे का?
+
+```py
+from transformers import AutoTokenizer, AutoModel
+
+tokenizer = AutoTokenizer.from_pretrained("bert-base-cased")
+model = AutoModel.from_pretrained("gpt2")
+
+encoded = tokenizer("Hey!", return_tensors="pt")
+result = model(**encoded)
+```
+
+
\ No newline at end of file