diff --git a/chapters/mr/chapter 0/1.mdx b/chapters/mr/chapter 0/1.mdx
new file mode 100644
index 000000000..b0b6b4319
--- /dev/null
+++ b/chapters/mr/chapter 0/1.mdx
@@ -0,0 +1,51 @@
+# परिचय[[introduction]]
+
+हगिंग फेस (Hugging Face) कोर्समध्ये आपले स्वागत आहे! हा परिचय तुम्हाला तुमचे वर्किंग एन्व्हायर्नमेंट (working environment) सेट करण्यासाठी मार्गदर्शन करेल. जर तुम्ही हा कोर्स नुकताच सुरू करत असाल, तर आम्ही शिफारस करतो की तुम्ही आधी [प्रकरण १](/course/chapter1) पहावे, आणि नंतर परत येऊन तुमचे एन्व्हायर्नमेंट सेट करावे म्हणजे तुम्ही स्वतः कोड चालवून पाहू शकाल.
+
+या कोर्समध्ये आपण वापरणार असलेल्या सर्व लायब्ररीज पायथन पॅकेजेस (Python packages) म्हणून उपलब्ध आहेत, त्यामुळे आपण येथे पायथन एन्व्हायर्नमेंट कसे सेट करायचे आणि आवश्यक असलेल्या विशिष्ट लायब्ररीज कशा इन्स्टॉल करायच्या हे पाहणार आहोत.
+
+आपण तुमचे वर्किंग एन्व्हायर्नमेंट सेट करण्याच्या दोन पद्धती पाहणार आहोत: कोलॅब नोटबुक (Colab notebook) वापरणे किंवा पायथन व्हर्च्युअल एन्व्हायर्नमेंट (Python virtual environment) वापरणे. तुम्हाला सर्वात योग्य वाटेल अशी पद्धत तुम्ही निवडू शकता. नवशिक्यांसाठी (beginners), आम्ही कोलॅब नोटबुक वापरून सुरुवात करण्याची जोरदार शिफारस करतो.
+
+लक्षात घ्या की आपण विंडोज सिस्टीम कव्हर करणार नाही आहोत. जर तुम्ही विंडोज वापरत असाल, तर आम्ही तुम्हाला कोलॅब नोटबुक वापरूनच हा कोर्स पुढे चालू ठेवण्याची शिफारस करतो. जर तुम्ही लिनक्स (Linux) डिस्ट्रिब्युशन किंवा मॅकओएस (macOS) वापरत असाल, तर तुम्ही येथे वर्णन केलेल्या दोनपैकी कोणतीही पद्धत वापरू शकता.
+
+कोर्सचा बहुतांश भाग तुमच्याकडे हगिंग फेस अकाउंट असण्यावर अवलंबून आहे. आम्ही आताच एक तयार करण्याची शिफारस करतो: [खाते तयार करा](https://huggingface.co/join).
+
+## गुगल कोलॅब नोटबुक वापरणे[[using-a-google-colab-notebook]]
+
+कोलॅब नोटबुक वापरणे हा सर्वात सोपा सेटअप आहे; तुमच्या ब्राउझरमध्ये नोटबुक सुरू करा आणि थेट कोडिंगला लागा!
+
+जर तुम्हाला कोलॅबची माहिती नसेल, तर आम्ही [परिचय](https://colab.research.google.com/notebooks/intro.ipynb) वाचून सुरुवात करण्याची शिफारस करतो. कोलॅब तुम्हाला GPU किंवा TPU सारखे काही प्रवेगक हार्डवेअर (accelerating hardware) वापरण्याची परवानगी देते, आणि ते लहान वर्कलोड्ससाठी मोफत आहे.
+
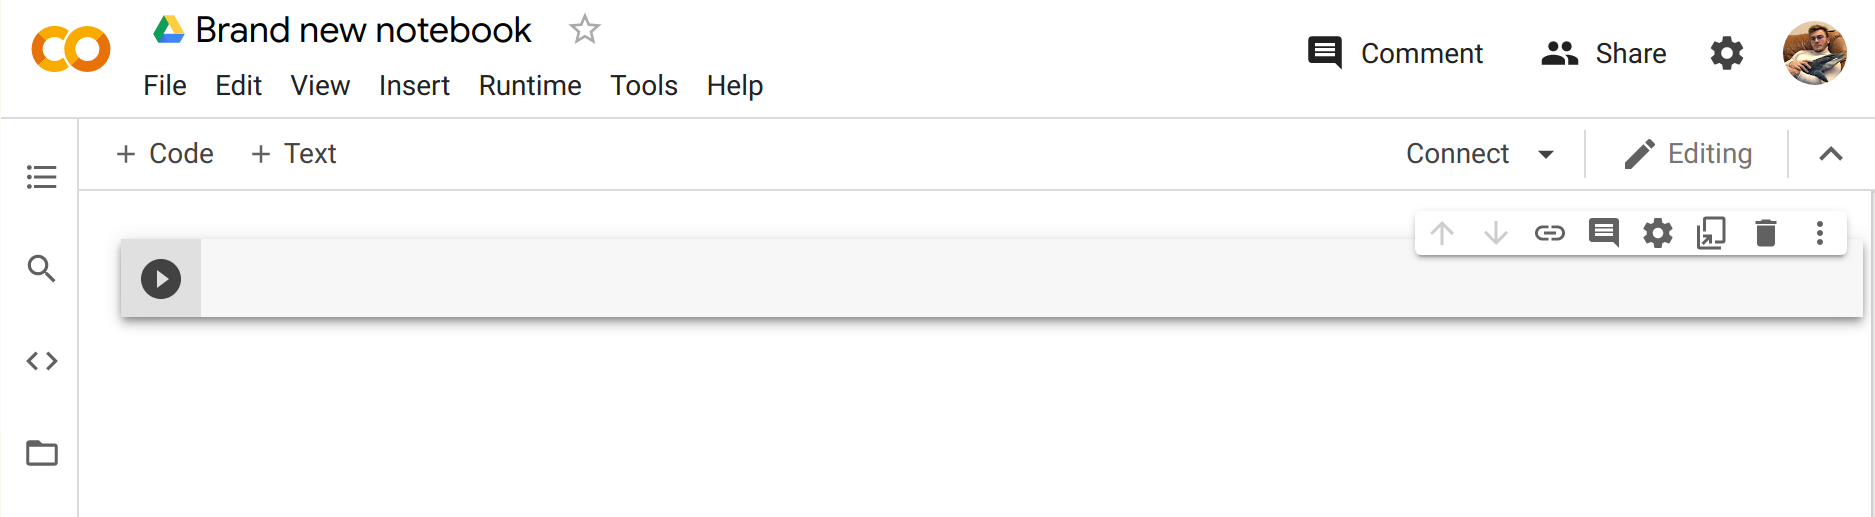
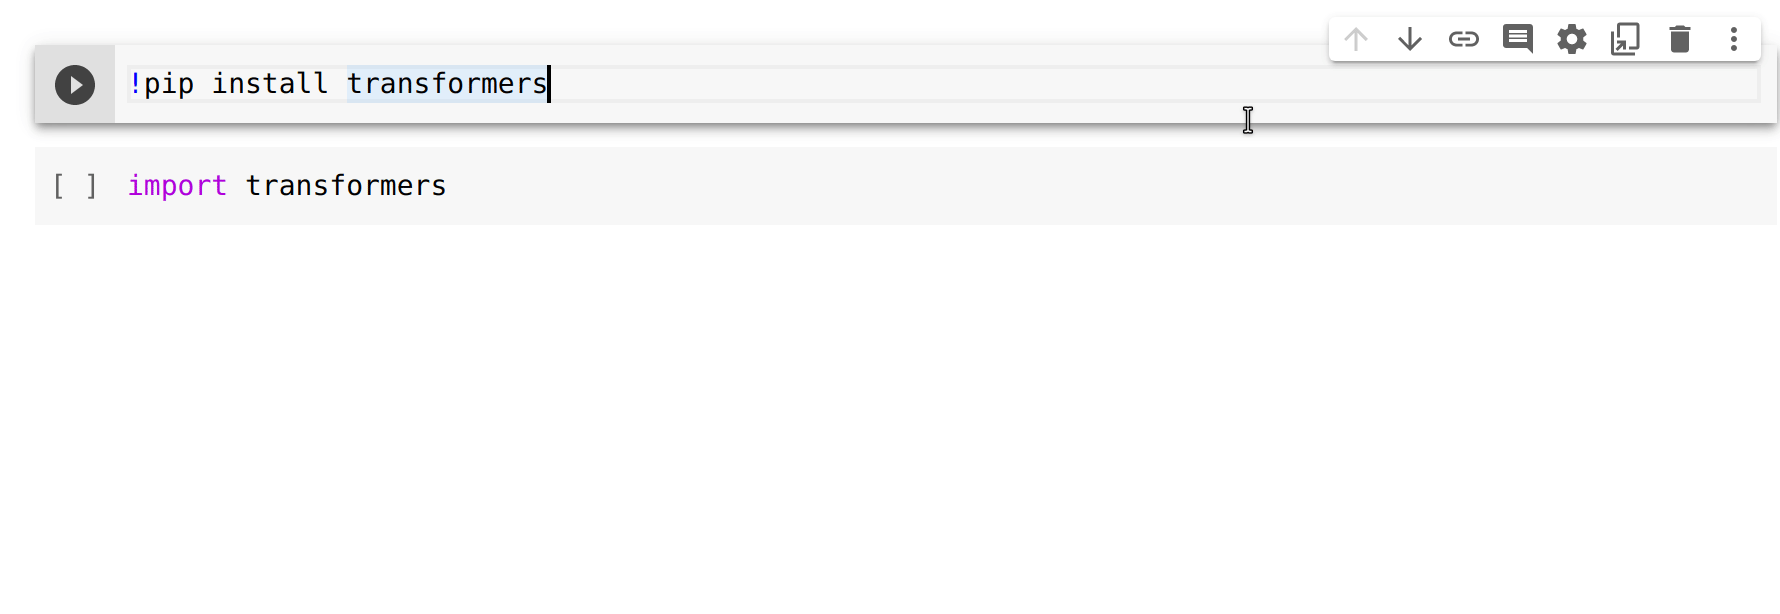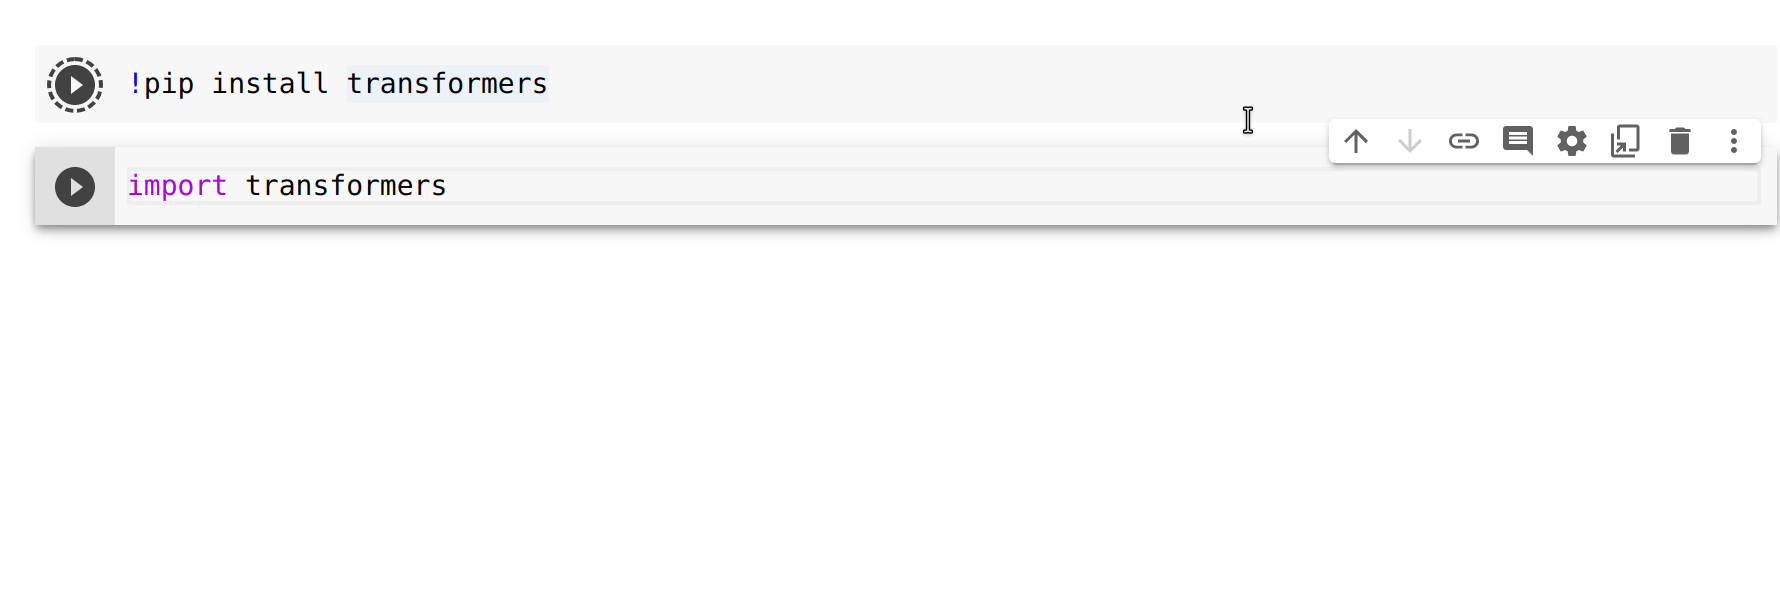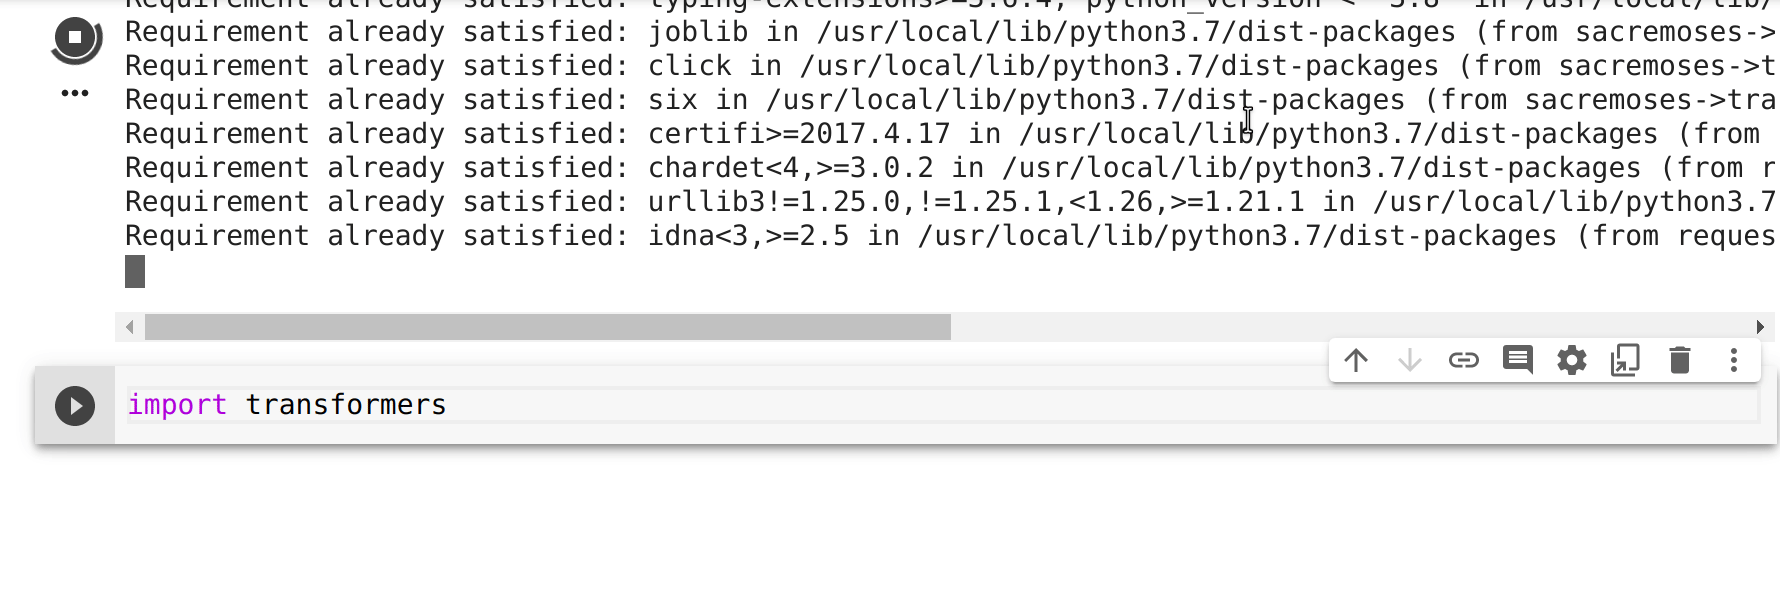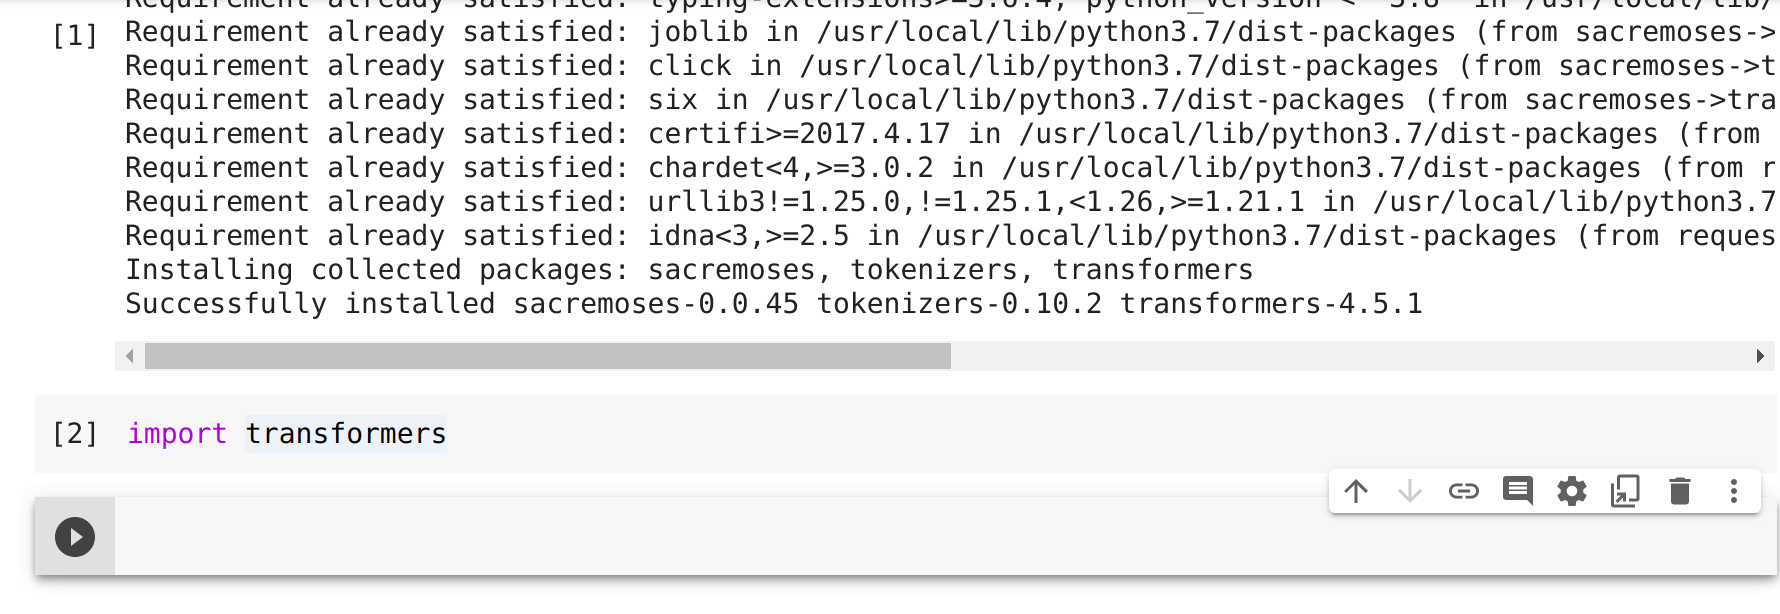
+एकदा तुम्हाला कोलॅबची चांगली ओळख झाल्यावर, नवीन नोटबुक तयार करा आणि सेटअपला सुरुवात करा:
+
+
+
+
+
+
+

+

+
 +
+लक्षात घ्या की कोर्स पूर्ण केल्यानंतर जर तुम्हाला अधिक सराव करायचा असेल तर फोरमवर [प्रोजेक्ट आयडियाज (project ideas)](https://discuss.huggingface.co/c/course/course-event/25) ची यादी देखील उपलब्ध आहे.
+
+- **मला कोर्ससाठीचा कोड कुठे मिळेल?**
+प्रत्येक विभागासाठी, Google Colab किंवा Amazon SageMaker Studio Lab मध्ये कोड चालवण्यासाठी (run) पृष्ठाच्या शीर्षस्थानी असलेल्या बॅनरवर क्लिक करा:
+
+
 +
+कोर्समधील सर्व कोड असलेल्या ज्युपिटर नोटबुक्स (Jupyter notebooks) [`huggingface/notebooks`](https://github.com/huggingface/notebooks) रेपोवर होस्ट केलेल्या आहेत. जर तुम्हाला त्या लोकली जनरेट करायच्या असतील, तर GitHub वरील [`course`](https://github.com/huggingface/course#-jupyter-notebooks) रेपो मधील सूचना पहा.
+
+- **मी कोर्समध्ये कसे योगदान देऊ शकतो?**
+कोर्समध्ये योगदान देण्याचे अनेक मार्ग आहेत! जर तुम्हाला एखादी टायपो (typo) किंवा बग (bug) आढळल्यास, कृपया [`course`](https://github.com/huggingface/course) रेपोवर एखादा इश्यू (issue) ओपन करा. जर तुम्हाला हा कोर्स तुमच्या मातृभाषेत अनुवादित करण्यात मदत करायची असेल, तर [येथे](https://github.com/huggingface/course#translating-the-course-into-your-language) दिलेल्या सूचना पहा.
+
+- **प्रत्येक भाषांतरासाठी कोणत्या निवडी केल्या गेल्या?**
+प्रत्येक भाषांतरासाठी एक शब्दकोष (glossary) आणि `TRANSLATING.txt` फाईल असते ज्यामध्ये मशीन लर्निंगमधील तांत्रिक शब्दांसाठी (jargon) केलेल्या निवडींचा तपशील दिलेला असतो. तुम्ही जर्मन भाषेसाठी एक उदाहरण [येथे](https://github.com/huggingface/course/blob/main/chapters/de/TRANSLATING.txt) शोधू शकता.
+
+- **मी हा कोर्स पुन्हा वापरू शकतो का?**
+नक्कीच! हा कोर्स परमिसिव्ह (permissive) [अपाचे २ लायसन्स (Apache 2 license)](https://www.apache.org/licenses/LICENSE-2.0.html) अंतर्गत प्रकाशित करण्यात आला आहे. याचा अर्थ असा की तुम्ही योग्य श्रेय (credit) दिले पाहिजे, लायसन्सची लिंक दिली पाहिजे आणि जर काही बदल केले असतील तर ते नमूद केले पाहिजेत. तुम्ही हे कोणत्याही वाजवी मार्गाने करू शकता, परंतु कोणत्याही प्रकारे परवाना देणाऱ्याने (licensor) तुम्हाला किंवा तुमच्या वापराला मान्यता दिली आहे असे सुचवता येणार नाही. जर तुम्हाला या कोर्सचा संदर्भ (cite) द्यायचा असेल, तर कृपया खालील BibTeX वापरा:
\ No newline at end of file
diff --git a/chapters/mr/chapter 1/10.mdx b/chapters/mr/chapter 1/10.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/11.mdx b/chapters/mr/chapter 1/11.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/2.mdx b/chapters/mr/chapter 1/2.mdx
new file mode 100644
index 000000000..1f856f6db
--- /dev/null
+++ b/chapters/mr/chapter 1/2.mdx
@@ -0,0 +1,52 @@
+# नॅचरल लँग्वेज प्रोसेसिंग आणि लार्ज लँग्वेज मॉडेल्स[[natural-language-processing-and-large-language-models]]
+
+
+
+ट्रान्सफॉर्मर (Transformer) मॉडेल्सकडे वळण्यापूर्वी, नॅचरल लँग्वेज प्रोसेसिंग म्हणजे काय, लार्ज लँग्वेज मॉडेल्सनी या क्षेत्रात कसा बदल घडवून आणला आहे आणि आपण त्याची काळजी का करतो, याचा थोडक्यात आढावा घेऊया.
+
+## NLP म्हणजे काय?[[what-is-nlp]]
+
+
+
+NLP हे भाषाशास्त्र (linguistics) आणि मशीन लर्निंगचे एक क्षेत्र आहे जे मानवी भाषेशी संबंधित सर्व काही समजून घेण्यावर केंद्रित आहे. NLP टास्कचा उद्देश केवळ एकेरी शब्दांचा स्वतंत्रपणे अर्थ समजून घेणे हा नसून, त्या शब्दांचा संदर्भ (context) समजून घेण्यास सक्षम असणे हा आहे.
+
+खाली काही सामान्य NLP टास्क्सची यादी त्यांच्या काही उदाहरणांसह दिली आहे:
+
+- **संपूर्ण वाक्यांचे वर्गीकरण करणे (Classifying whole sentences)**: रिव्ह्यूचे सेंटिमेंट (sentiment) मिळवणे, ईमेल स्पॅम आहे की नाही हे शोधणे, वाक्य व्याकरणदृष्ट्या योग्य आहे की नाही किंवा दोन वाक्ये तार्किकदृष्ट्या संबंधित आहेत की नाही हे ठरवणे.
+- **वाक्यातील प्रत्येक शब्दाचे वर्गीकरण करणे**: वाक्यातील व्याकरणाचे घटक (नाम, क्रियापद, विशेषण) किंवा नेम्ड एंटिटीज (व्यक्ती, ठिकाण, संस्था) ओळखणे.
+- **टेक्स्ट कंटेंट तयार करणे (Generating text content)**: ऑटोजेनरेटेड (auto-generated) टेक्स्टसह प्रॉम्प्ट पूर्ण करणे, टेक्स्ट मधील रिकाम्या जागा मास्क्ड (masked) शब्दांनी भरणे.
+- **टेक्स्ट मधून उत्तर काढणे**: दिलेला प्रश्न आणि संदर्भ (context) यावर आधारित, संदर्भात दिलेल्या माहितीवरून प्रश्नाचे उत्तर शोधून काढणे.
+- **इनपुट टेक्स्ट वरून नवीन वाक्य तयार करणे**: टेक्स्टचा दुसऱ्या भाषेत अनुवाद करणे, टेक्स्टचा सारांश (summarizing) काढणे.
+
+तथापि, NLP केवळ लिखित टेक्स्टपुरते मर्यादित नाही. ते स्पीच रेकग्निशन (speech recognition) आणि कॉम्प्युटर व्हिजनमधील (computer vision) जटिल आव्हानांना देखील सामोरे जाते, जसे की ऑडिओ सॅम्पलची ट्रान्सक्रिप्ट किंवा इमेजचे वर्णन तयार करणे.
+
+## लार्ज लँग्वेज मॉडेल्सचा (LLMs) उदय[[rise-of-llms]]
+
+अलिकडच्या वर्षांत, लार्ज लँग्वेज मॉडेल्सनी (LLMs) NLP क्षेत्रात क्रांती घडवून आणली आहे. GPT (जनरेटिव्ह प्री-ट्रेन्ड ट्रान्सफॉर्मर) आणि [Llama](https://huggingface.co/meta-llama) सारख्या आर्किटेक्चर्सचा समावेश असलेल्या या मॉडेल्सनी लँग्वेज प्रोसेसिंगमध्ये काय शक्य आहे हे पूर्णपणे बदलून टाकले आहे.
+
+> [!TIP]
+> लार्ज लँग्वेज मॉडेल (LLM) हे एक AI मॉडेल आहे जे मोठ्या प्रमाणातील टेक्स्ट डेटावर ट्रेन केलेले असते आणि ते मानवासारखे टेक्स्ट समजून घेऊ आणि तयार करू शकते, भाषेतील पॅटर्न ओळखू शकते आणि कोणत्याही विशिष्ट टास्कच्या ट्रेनिंगशिवाय अनेक प्रकारची भाषिक कार्ये करू शकते. ते नॅचरल लँग्वेज प्रोसेसिंग (NLP) क्षेत्रातील एक महत्त्वपूर्ण प्रगती दर्शवतात.
+
+LLMs ची वैशिष्ट्ये खालीलप्रमाणे आहेत:
+- **स्केल (Scale)**: त्यांच्यात लाखो, अब्जावधी किंवा शेकडो अब्जावधी पॅरामीटर्स (parameters) असतात.
+- **सामान्य क्षमता (General capabilities)**: ते टास्क-विशिष्ट (task-specific) ट्रेनिंगशिवाय अनेक कार्ये करू शकतात.
+- **इन-कॉन्टेक्स्ट लर्निंग (In-context learning)**: ते प्रॉम्प्टमध्ये दिलेल्या उदाहरणांवरून शिकू शकतात.
+- **इमर्जंट ॲबिलिटीज (Emergent abilities)**: जसजसा या मॉडेल्सचा आकार वाढतो, तसतसे ते अशा क्षमता दाखवतात ज्या स्पष्टपणे प्रोग्राम केलेल्या किंवा अपेक्षित नव्हत्या.
+
+LLMs च्या आगमनाने विशिष्ट NLP कार्यांसाठी विशेष मॉडेल्स तयार करण्याच्या पद्धतीकडून एकाच, मोठ्या मॉडेलचा वापर करण्याकडे एक स्थित्यंतर (paradigm shift) घडवून आणले आहे, ज्याला विविध भाषिक कार्यांसाठी प्रॉम्प्ट किंवा फाइन-ट्यून (fine-tune) केले जाऊ शकते. यामुळे प्रगत लँग्वेज प्रोसेसिंग अधिक सुलभ झाले आहे, पण सोबतच कार्यक्षमता, नैतिकता (ethics) आणि डिप्लॉयमेंट यांसारख्या क्षेत्रांमध्ये नवीन आव्हाने देखील उभी केली आहेत.
+
+तथापि, LLMs च्या काही महत्त्वाच्या मर्यादा देखील आहेत:
+- **हॅलुसिनेशन्स (Hallucinations)**: ते अत्यंत आत्मविश्वासाने चुकीची माहिती तयार करू शकतात.
+- **खऱ्या समजेचा अभाव**: त्यांच्याकडे जगाची खरी समज नसते आणि ते पूर्णपणे सांख्यिकीय पॅटर्नवर (statistical patterns) कार्य करतात.
+- **बायस (Bias / पूर्वग्रह)**: ते त्यांच्या ट्रेनिंग डेटामध्ये किंवा इनपुटमध्ये असलेले पूर्वग्रह पुन्हा निर्माण करू शकतात.
+- **कॉन्टेक्स्ट विंडोज (Context windows)**: त्यांच्याकडे मर्यादित कॉन्टेक्स्ट विंडोज असतात (जरी यामध्ये सुधारणा होत असली तरीही).
+- **कम्प्युटेशनल रिसोर्सेस (Computational resources)**: त्यांना मोठ्या प्रमाणावर संगणकीय संसाधनांची आवश्यकता असते.
+
+## लँग्वेज प्रोसेसिंग आव्हानात्मक का आहे?[[why-is-it-challenging]]
+
+संगणक माणसांप्रमाणे माहितीवर प्रक्रिया करत नाहीत. उदाहरणार्थ, जेव्हा आपण "मला भूक लागली आहे" हे वाक्य वाचतो, तेव्हा आपण त्याचा अर्थ सहज समजू शकतो. त्याचप्रमाणे, "मला भूक लागली आहे" आणि "मी दुःखी आहे" यासारखी दोन वाक्ये दिली असता, त्यांच्यात किती साम्य आहे हे आपण सहज ठरवू शकतो. मशीन लर्निंग (ML) मॉडेल्ससाठी अशी कार्ये अधिक कठीण असतात. टेक्स्टवर अशा प्रकारे प्रक्रिया करणे आवश्यक आहे ज्यामुळे मॉडेलला त्यातून शिकण्यास सक्षम करता येईल. आणि भाषा अत्यंत क्लिष्ट असल्यामुळे, ही प्रक्रिया कशी केली जावी याबद्दल आपल्याला काळजीपूर्वक विचार करणे आवश्यक आहे. टेक्स्टचे प्रतिनिधित्व (represent) कसे करावे यावर बरेच संशोधन झाले आहे, आणि आपण पुढील प्रकरणात काही पद्धती पाहणार आहोत.
+
+LLMs मधील प्रगतीनंतरही, अनेक मूलभूत आव्हाने अजूनही कायम आहेत. यामध्ये संदिग्धता (ambiguity), सांस्कृतिक संदर्भ, उपहास (sarcasm) आणि विनोद समजून घेणे यांचा समावेश आहे. विविध प्रकारच्या डेटासेटवर मोठ्या प्रमाणावर ट्रेनिंग देऊन LLMs या आव्हानांना सामोरे जातात, परंतु अनेक गुंतागुंतीच्या परिस्थितींमध्ये मानवी पातळीवरील समजूतदारपणाच्या तुलनेत ते अजूनही कमी पडतात.
diff --git a/chapters/mr/chapter 1/3.mdx b/chapters/mr/chapter 1/3.mdx
new file mode 100644
index 000000000..68492950a
--- /dev/null
+++ b/chapters/mr/chapter 1/3.mdx
@@ -0,0 +1,49 @@
+ट्रान्सफॉर्मर्स, ते काय करू शकतात?[[transformers-what-can-they-do]]
+
+या विभागात, आपण ट्रान्सफॉर्मर मॉडेल्स काय करू शकतात हे पाहू आणि 🤗 Transformers लायब्ररीतील आपले पहिले साधन वापरू: pipeline() फंक्शन.
+
+[!TIP] 👀 वर उजवीकडे Open in Colab बटण दिसतंय का? या विभागातील सर्व कोड उदाहरणांसह Google Colab नोटबुक उघडण्यासाठी त्यावर क्लिक करा. कोड उदाहरणे असलेल्या प्रत्येक विभागात हे बटण दिसेल.
+
+जर तुम्हाला उदाहरणे स्थानिक पातळीवर (locally) चालवायची असतील, तर सेटअप पाहण्याची शिफारस करतो.
+
+ट्रान्सफॉर्मर्स सर्वत्र आहेत![[transformers-are-everywhere]]
+
+नैसर्गिक भाषा प्रक्रिया (NLP), संगणकीय दृष्टी (computer vision), ऑडिओ प्रक्रिया आणि इतर विविध क्षेत्रांतील सर्व प्रकारची कामे सोडवण्यासाठी ट्रान्सफॉर्मर मॉडेल्स वापरली जातात. Hugging Face आणि ट्रान्सफॉर्मर मॉडेल्स वापरणाऱ्या आणि समुदायाला परत योगदान देणाऱ्या (त्यांची मॉडेल्स शेअर करून) काही कंपन्या आणि संस्था इथे दाखवल्या आहेत:
+
+
 +
+🤗 Transformers लायब्ररी ही शेअर केलेली मॉडेल्स तयार करण्याची आणि वापरण्याची क्षमता पुरवते. Model Hub मध्ये लाखो प्रशिक्षित (pretrained) मॉडेल्स आहेत, जी कोणीही डाउनलोड करून वापरू शकतं. तुम्ही तुमची स्वतःची मॉडेल्ससुद्धा Hub वर अपलोड करू शकता!
+
+[!TIP] ⚠️ Hugging Face Hub फक्त ट्रान्सफॉर्मर मॉडेल्सपुरतं मर्यादित नाही. कोणीही कोणत्याही प्रकारची मॉडेल्स किंवा डेटासेट्स शेअर करू शकतो! सर्व उपलब्ध वैशिष्ट्यांचा लाभ घेण्यासाठी huggingface.co खातं तयार करा!
+
+ट्रान्सफॉर्मर मॉडेल्स आतून कशी काम करतात हे पाहण्याआधी, काही मनोरंजक NLP समस्या सोडवण्यासाठी ती कशी वापरली जाऊ शकतात याची काही उदाहरणं पाहूया.
+
+पाइपलाइन्ससोबत काम करणे[[working-with-pipelines]]
+
+🤗 Transformers लायब्ररीतील सर्वात मूलभूत ऑब्जेक्ट म्हणजे pipeline() फंक्शन. हे मॉडेलला त्याच्या आवश्यक प्री-प्रोसेसिंग आणि पोस्ट-प्रोसेसिंग पायऱ्यांशी जोडतं, ज्यामुळे आपण थेट कोणताही मजकूर इनपुट करून समजण्याजोगं उत्तर मिळवू शकतो:
+
+python
+from transformers import pipeline
+
+classifier = pipeline("sentiment-analysis")
+classifier("I've been waiting for a HuggingFace course my whole life.")
+python
+[{'label': 'POSITIVE', 'score': 0.9598047137260437}]
+
+आपण अनेक वाक्येसुद्धा एकत्र पाठवू शकतो!
+
+python
+classifier(
+ ["I've been waiting for a HuggingFace course my whole life.", "I hate this so much!"]
+)
+python
+[{'label': 'POSITIVE', 'score': 0.9598047137260437},
+ {'label': 'NEGATIVE', 'score': 0.9994558095932007}]
+
+डिफॉल्टनुसार, ही पाइपलाइन इंग्रजीतील भावना विश्लेषणासाठी (sentiment analysis) फाइन-ट्यून केलेलं एक विशिष्ट पूर्व-प्रशिक्षित मॉडेल निवडते. जेव्हा तुम्ही classifier ऑब्जेक्ट तयार करता, तेव्हा मॉडेल डाउनलोड होऊन कॅश (cache) होतं. जर तुम्ही कमांड पुन्हा चालवली, तर कॅश केलेलं मॉडेल वापरलं जाईल आणि पुन्हा डाउनलोड करण्याची गरज पडणार नाही.
+
+जेव्हा तुम्ही पाइपलाइनला काही मजकूर पाठवता, तेव्हा तीन मुख्य पायऱ्या घडतात:
+
+मजकूर मॉडेलला समजेल अशा स्वरूपात प्री-प्रोसेस केला जातो.
+प्री-प्रोसेस केलेले इनपुट मॉडेलकडे पाठवले जातात.
+मॉडेलचे अंदाज (predictions) पोस्ट-प्रोसेस केले जातात, जेणेकरून तुम्हाला त्यांचा अर्थ समजू शकेल.
\ No newline at end of file
diff --git a/chapters/mr/chapter 1/4.mdx b/chapters/mr/chapter 1/4.mdx
new file mode 100644
index 000000000..a89ab03df
--- /dev/null
+++ b/chapters/mr/chapter 1/4.mdx
@@ -0,0 +1,133 @@
+ट्रान्सफॉर्मर्स कसे काम करतात?[[how-do-transformers-work]]
+या विभागात, आपण ट्रान्सफॉर्मर मॉडेल्सच्या आर्किटेक्चर (रचनेवर) एक नजर टाकू आणि अटेन्शन, एन्कोडर-डिकोडर आर्किटेक्चर आणि इतर संकल्पना अधिक सखोलपणे समजून घेऊ.
+
+[!WARNING]
+🚀 आपण येथे एक पाऊल पुढे टाकत आहोत. हा विभाग तपशीलवार आणि तांत्रिक आहे, त्यामुळे तुम्हाला सर्व काही लगेच समजले नाही तरी काळजी करू नका. आपण या कोर्समध्ये नंतर या संकल्पनांवर पुन्हा सविस्तर चर्चा करू.
+
+ट्रान्सफॉर्मरचा थोडा इतिहास[[a-bit-of-transformer-history]]
+ट्रान्सफॉर्मर मॉडेल्सच्या (लहान) इतिहासातील काही महत्त्वाचे टप्पे (reference points) येथे दिले आहेत:
+
+ट्रान्सफॉर्मर आर्किटेक्चर जून २०१७ मध्ये सादर केले गेले. मूळ संशोधनाचा मुख्य भर भाषांतर (translation) कार्यांवर होता. यानंतर अनेक प्रभावशाली मॉडेल्स सादर केली गेली, ज्यामध्ये खालील मॉडेल्सचा समावेश आहे:
+
+जून २०१८: GPT, पहिले प्री-ट्रेंड ट्रान्सफॉर्मर मॉडेल, जे विविध NLP (नॅचरल लँग्वेज प्रोसेसिंग) कार्यांवर फाइन-ट्युनिंगसाठी वापरले गेले आणि ज्याने उत्कृष्ट (state-of-the-art) परिणाम मिळवले.
+
+ऑक्टोबर २०१८: BERT, दुसरे मोठे प्री-ट्रेंड मॉडेल, जे वाक्यांचे अधिक चांगले सारांश तयार करण्यासाठी डिझाइन केले गेले (पुढील प्रकरणात याबद्दल अधिक माहिती!).
+
+फेब्रुवारी २०१९: GPT-2, GPT ची सुधारित (आणि मोठी) आवृत्ती जी नैतिक चिंतांमुळे (ethical concerns) त्वरित सार्वजनिकपणे प्रदर्शित केली गेली नाही.
+
+ऑक्टोबर २०१९: T5, सिक्वेन्स-टू-सिक्वेन्स ट्रान्सफॉर्मर आर्किटेक्चरचे मल्टी-टास्क केंद्रित अंमलबजावणी मॉडेल.
+
+मे २०२०: GPT-3, GPT-2 ची आणखी मोठी आवृत्ती जी फाइन-ट्युनिंगच्या गरजेशिवाय विविध कामे उत्तम प्रकारे करू शकते (याला झिरो-शॉट लर्निंग म्हणतात).
+
+जानेवारी २०२२: InstructGPT, GPT-3 ची एक आवृत्ती ज्याला सूचनांचे (instructions) अधिक चांगल्या प्रकारे पालन करण्यासाठी प्रशिक्षित केले गेले.
+
+जानेवारी २०२३: Llama, एक लार्ज लँग्वेज मॉडेल (LLM) जे विविध भाषांमध्ये मजकूर तयार करू शकते.
+
+मार्च २०२३: Mistral, ७-अब्ज-पॅरामीटर्सचे लँग्वेज मॉडेल जे Llama 2 13B ला सर्व मूल्यमापन केलेल्या बेंचमार्कवर मागे टाकते. हे जलद इन्फरन्ससाठी ग्रुप्ड-क्वेरी अटेन्शन (grouped-query attention) आणि कोणत्याही लांबीच्या सिक्वेन्स हाताळण्यासाठी स्लाइडिंग विंडो अटेन्शन (sliding window attention) चा वापर करते.
+
+मे २०२४: Gemma 2, २ अब्ज (2B) ते २७ अब्ज (27B) पॅरामीटर्सपर्यंतच्या हलक्या (lightweight), अत्याधुनिक ओपन मॉडेल्सचा समूह, ज्यामध्ये इंटरलीव्ह्ड लोकल-ग्लोबल अटेन्शन आणि ग्रुप-क्वेरी अटेन्शन समाविष्ट आहे. यातील लहान मॉडेल्स नॉलेज डिस्टिलेशन (knowledge distillation) वापरून प्रशिक्षित केली गेली आहेत, जी त्यांच्यापेक्षा २-३ पट मोठ्या मॉडेल्सच्या तुलनेत उत्कृष्ट कामगिरी देतात.
+
+नोव्हेंबर २०२४: SmolLM2, एक अत्याधुनिक लहान लँग्वेज मॉडेल (१३५ दशलक्ष ते १.७ अब्ज पॅरामीटर्स) जे त्याच्या लहान आकारमान असूनही प्रभावी कामगिरी साध्य करते आणि मोबाइल आणि एज (edge) उपकरणांसाठी नवीन शक्यता उघडते.
+
+ही यादी पूर्णपणे सर्वसमावेशक नाही, आणि ती फक्त काही वेगवेगळ्या प्रकारच्या ट्रान्सफॉर्मर मॉडेल्सवर प्रकाश टाकण्यासाठी आहे. सामान्यतः, त्यांना तीन श्रेणींमध्ये विभागले जाऊ शकते:
+
+GPT-सारखे (ज्यांना ऑटो-रिग्रेसिव्ह ट्रान्सफॉर्मर मॉडेल्स असेही म्हणतात)
+
+BERT-सारखे (ज्यांना ऑटो-एन्कोडिंग ट्रान्सफॉर्मर मॉडेल्स असेही म्हणतात)
+
+T5-सारखे (ज्यांना सिक्वेन्स-टू-सिक्वेन्स ट्रान्सफॉर्मर मॉडेल्स असेही म्हणतात)
+
+आपण पुढे या श्रेणींबद्दल (families) अधिक सविस्तर जाणून घेऊ.
+
+ट्रान्सफॉर्मर्स हे लँग्वेज मॉडेल्स आहेत[[transformers-are-language-models]]
+वर नमूद केलेली सर्व ट्रान्सफॉर्मर मॉडेल्स (GPT, BERT, T5 इ.) लँग्वेज मॉडेल्स (भाषा मॉडेल्स) म्हणून प्रशिक्षित केली गेली आहेत. याचा अर्थ त्यांना सेल्फ-सुपरवाइज्ड (self-supervised) पद्धतीने मोठ्या प्रमाणातील कच्च्या (raw) मजकुरावर प्रशिक्षित केले गेले आहे.
+
+सेल्फ-सुपरवाइज्ड लर्निंग (Self-supervised learning) हा प्रशिक्षणाचा एक प्रकार आहे ज्यामध्ये मॉडेलच्या इनपुटमधून उद्दिष्ट (objective) स्वयंचलितपणे मोजले जाते. याचा अर्थ असा की डेटाला लेबल करण्यासाठी मानवांची आवश्यकता नाही!
+
+अशा प्रकारचे मॉडेल ज्या भाषेवर प्रशिक्षित केले जाते, तिची सांख्यिकीय (statistical) समज विकसित करते, परंतु ते विशिष्ट व्यावहारिक कार्यांसाठी कमी उपयुक्त असते. यामुळे, सामान्य प्री-ट्रेंड मॉडेल त्यानंतर ट्रान्सफर लर्निंग (transfer learning) किंवा फाइन-ट्युनिंग (fine-tuning) नावाच्या प्रक्रियेतून जाते. या प्रक्रियेदरम्यान, मॉडेलला एखाद्या विशिष्ट कार्यासाठी सुपरवाइज्ड पद्धतीने -- म्हणजेच, मानवी-चिन्हांकित लेबल्स वापरून -- फाइन-ट्यून केले जाते.
+
+एखाद्या कार्याचे उदाहरण म्हणजे n मागील शब्द वाचून वाक्यातील पुढील शब्दाचा अंदाज लावणे (predict करणे). याला कॉझल लँग्वेज मॉडेलिंग (causal language modeling) म्हणतात कारण आउटपुट भूतकाळातील आणि वर्तमान इनपुट्सवर अवलंबून असते, परंतु भविष्यातील इनपुट्सवर नाही.
+
+दुसरे उदाहरण म्हणजे मास्क्ड लँग्वेज मॉडेलिंग (masked language modeling), ज्यामध्ये मॉडेल वाक्यातील लपवलेल्या (masked) शब्दाचा अंदाज लावते.
+
+ट्रान्सफॉर्मर्स हे मोठे मॉडेल्स आहेत[[transformers-are-big-models]]
+(DistilBERT सारखे) काही अपवाद वगळता, चांगली कामगिरी मिळवण्यासाठी सामान्य धोरण म्हणजे मॉडेल्सचा आकार वाढवणे तसेच त्यांना ज्या डेटावर प्री-ट्रेन केले जाते त्याचे प्रमाण वाढवणे.
+
+दुर्दैवाने, मॉडेलला प्रशिक्षित करण्यासाठी, विशेषतः मोठ्या मॉडेलला, मोठ्या प्रमाणावर डेटा लागतो. हे वेळ आणि संगणकीय संसाधनांच्या (compute resources) बाबतीत खूप खर्चिक बनते. खालील आलेखात पाहिल्याप्रमाणे, याचा पर्यावरणावर देखील परिणाम होतो.
+
+आणि हे एका (खूप मोठ्या) मॉडेलच्या प्रकल्पासाठी दर्शविले आहे ज्याचे नेतृत्व अशा टीमने केले आहे जे प्री-ट्रेनिंगचा पर्यावरणीय प्रभाव जाणीवपूर्वक कमी करण्याचा प्रयत्न करत आहेत. सर्वोत्तम हायपरपॅरामीटर्स मिळवण्यासाठी अनेक चाचण्या घेण्याचा पर्यावरणीय प्रभाव (carbon footprint) याहूनही जास्त असेल.
+
+कल्पना करा की प्रत्येक वेळी एखादी संशोधन संस्था, विद्यार्थी संघटना किंवा कंपनीला मॉडेल प्रशिक्षित करायचे असेल, आणि त्यांनी ते शून्यापासून (from scratch) सुरू केले तर काय होईल. यामुळे मोठ्या प्रमाणावर अनावश्यक जागतिक खर्च वाढेल!
+
+म्हणूनच लँग्वेज मॉडेल्स शेअर करणे अत्यंत महत्त्वाचे आहे: प्रशिक्षित वेट्स (trained weights) सामायिक करणे आणि आधीच प्रशिक्षित असलेल्या वेट्सच्या आधारे पुढील काम करणे यामुळे समुदायाचा एकूण संगणकीय खर्च आणि कार्बन फूटप्रिंट कमी होतो.
+
+तसे पाहता, तुम्ही तुमच्या मॉडेल्सच्या प्रशिक्षणाचा कार्बन फूटप्रिंट अनेक साधनांद्वारे मोजू शकता. उदाहरणार्थ, ML CO2 Impact किंवा Code Carbon जे 🤗 Transformers मध्ये समाकलित (integrated) केले आहे. याबद्दल अधिक जाणून घेण्यासाठी, तुम्ही ही ब्लॉग पोस्ट वाचू शकता जी तुम्हाला तुमच्या प्रशिक्षणाच्या फूटप्रिंटचा अंदाज असलेल्या emissions.csv फाइल कशी तयार करायची ते दर्शवेल, तसेच 🤗 Transformers चे डॉक्युमेंटेशन जे या विषयावर मार्गदर्शन करते.
+
+ट्रान्सफर लर्निंग (Transfer Learning)[[transfer-learning]]
+प्री-ट्रेनिंग (Pretraining) म्हणजे एखाद्या मॉडेलला शून्यापासून (from scratch) प्रशिक्षित करण्याची प्रक्रिया: यामध्ये वेट्स (weights) यादृच्छिकपणे (randomly) सुरू केले जातात आणि कोणत्याही पूर्वज्ञानाशिवाय प्रशिक्षण सुरू होते.
+
+हे प्री-ट्रेनिंग सहसा अत्यंत मोठ्या प्रमाणातील डेटावर केले जाते. त्यामुळे, यासाठी डेटाचा खूप मोठा संग्रह (corpus) लागतो, आणि प्रशिक्षणासाठी कित्येक आठवडे लागू शकतात.
+
+दुसरीकडे, फाइन-ट्युनिंग (Fine-tuning) हे मॉडेलला प्री-ट्रेन केल्यानंतर केले जाणारे प्रशिक्षण आहे. फाइन-ट्युनिंग करण्यासाठी, तुम्ही आधी एक प्री-ट्रेंड लँग्वेज मॉडेल मिळवता, आणि नंतर तुमच्या विशिष्ट कार्यासाठी तयार केलेल्या डेटासेटसह अतिरिक्त प्रशिक्षण देता. थांबा -- तुमच्या अंतिम उपयोगासाठी (use case) मॉडेलला सुरुवातीपासूनच (शून्यापासून/scratch) का प्रशिक्षित करू नये? याची काही कारणे आहेत:
+
+प्री-ट्रेंड मॉडेल आधीच अशा डेटासेटवर प्रशिक्षित केलेले असते ज्याचे फाइन-ट्युनिंग डेटासेटशी काही साधर्म्य असते. त्यामुळे फाइन-ट्युनिंग प्रक्रिया प्रारंभिक मॉडेलने प्री-ट्रेनिंग दरम्यान मिळवलेल्या ज्ञानाचा फायदा घेऊ शकते (उदाहरणार्थ, NLP समस्यांमध्ये, प्री-ट्रेंड मॉडेलला तुम्ही तुमच्या कामासाठी वापरत असलेल्या भाषेची काही प्रमाणात सांख्यिकीय समज असेल).
+
+प्री-ट्रेंड मॉडेल आधीच भरपूर डेटावर प्रशिक्षित झालेले असल्याने, चांगले परिणाम मिळवण्यासाठी फाइन-ट्युनिंगला खूप कमी डेटा लागतो.
+
+याच कारणामुळे, चांगले परिणाम मिळवण्यासाठी लागणारा वेळ आणि संसाधने खूप कमी असतात.
+
+उदाहरणार्थ, इंग्रजी भाषेवर प्रशिक्षित केलेले एखादे प्री-ट्रेंड मॉडेल वापरून नंतर ते arXiv कॉर्पसवर (विज्ञान संशोधनातील पेपर्स) फाइन-ट्यून केले जाऊ शकते, ज्यामुळे विज्ञान/संशोधन-आधारित मॉडेल तयार होईल. या फाइन-ट्युनिंगला फक्त मर्यादित प्रमाणात डेटा लागेल: प्री-ट्रेंड मॉडेलने जे ज्ञान आधीच मिळवले आहे ते "हस्तांतरित" (transferred) केले जाते, म्हणूनच याला ट्रान्सफर लर्निंग (transfer learning) असे म्हणतात.
+
+मॉडेल फाइन-ट्यून करण्यामुळे वेळ, डेटा, आर्थिक खर्च आणि पर्यावरणीय प्रभाव कमी असतो. वेगवेगळ्या फाइन-ट्युनिंग योजनांवर काम करणे देखील अधिक जलद आणि सोपे असते, कारण हे प्रशिक्षण पूर्ण प्री-ट्रेनिंगपेक्षा कमी वेळखाऊ असते.
+
+या प्रक्रियेमुळे शून्यापासून प्रशिक्षण देण्याच्या तुलनेत (तुमच्याकडे भरपूर डेटा असल्याशिवाय) चांगले परिणाम मिळतील. म्हणूनच तुम्ही नेहमी एखाद्या प्री-ट्रेंड मॉडेलचा फायदा घेण्याचा प्रयत्न केला पाहिजे -- जे मॉडेल तुमच्या कामाशी शक्य तितके जवळचे असेल -- आणि त्याला फाइन-ट्यून केले पाहिजे.
+
+सामान्य ट्रान्सफॉर्मर आर्किटेक्चर[[general-transformer-architecture]]
+या विभागात, आपण ट्रान्सफॉर्मर मॉडेलच्या सामान्य आर्किटेक्चरवर (रचनेवर) चर्चा करू. तुम्हाला काही संकल्पना समजल्या नाहीत तर काळजी करू नका; पुढील भागांमध्ये प्रत्येक घटकावर सविस्तर चर्चा केली आहे.
+
+हे मॉडेल प्रामुख्याने दोन ब्लॉक्सचे बनलेले असते:
+
+एन्कोडर (डावीकडे): एन्कोडरला इनपुट मिळते आणि तो त्याचे प्रतिनिधित्व (representation) म्हणजेच वैशिष्ट्ये (features) तयार करतो. याचा अर्थ असा की हे मॉडेल इनपुटमधून समज मिळवण्यासाठी अनुकूल (optimized) केलेले असते.
+
+डिकोडर (उजवीकडे): डिकोडर टार्गेट सिक्वेन्स (लक्ष्य क्रम) तयार करण्यासाठी एन्कोडरचे प्रतिनिधित्व (वैशिष्ट्ये) आणि इतर इनपुट्स वापरतो. याचा अर्थ असा की हे मॉडेल आउटपुट जनरेट करण्यासाठी अनुकूल केलेले असते.
+
+कामाच्या स्वरूपानुसार हे दोन्ही भाग स्वतंत्रपणे वापरले जाऊ शकतात:
+
+फक्त-एन्कोडर मॉडेल्स (Encoder-only models): वाक्यांचे वर्गीकरण (sentence classification) आणि नेम्ड एंटिटी रेकग्निशन (named entity recognition) यासारख्या इनपुट समजून घेण्याची आवश्यकता असलेल्या कार्यांसाठी चांगले.
+
+फक्त-डिकोडर मॉडेल्स (Decoder-only models): मजकूर निर्मितीसारख्या (text generation) जनरेटिव्ह (generative) कार्यांसाठी चांगले.
+
+एन्कोडर-डिकोडर मॉडेल्स किंवा सिक्वेन्स-टू-सिक्वेन्स मॉडेल्स: भाषांतर (translation) किंवा सारांश (summarization) यासारख्या इनपुटची आवश्यकता असलेल्या जनरेटिव्ह कार्यांसाठी चांगले.
+
+आपण पुढील विभागांमध्ये या आर्किटेक्चर्सबद्दल स्वतंत्रपणे सविस्तर माहिती घेऊ.
+
+अटेन्शन लेयर्स (Attention layers)[[attention-layers]]
+ट्रान्सफॉर्मर मॉडेल्सचे एक प्रमुख वैशिष्ट्य म्हणजे ते अटेन्शन लेयर्स (attention layers) नावाच्या विशेष स्तरांनी बनलेले असतात. किंबहुना, ट्रान्सफॉर्मर आर्किटेक्चर सादर करणाऱ्या पेपरचे शीर्षकच "Attention Is All You Need" असे होते! आपण कोर्समध्ये नंतर अटेन्शन लेयर्सचे तपशील पाहू; सध्या तुम्हाला फक्त एवढेच माहित असणे आवश्यक आहे की हा लेयर मॉडेलला प्रत्येक शब्दाच्या प्रतिनिधित्वावर (representation) काम करताना, तुम्ही दिलेल्या वाक्यातील विशिष्ट शब्दांवर विशेष लक्ष देण्यास (आणि बाकीच्यांकडे कमी लक्ष देण्यास किंवा दुर्लक्ष करण्यास) सांगतो.
+
+हे संदर्भासह समजून घेण्यासाठी, इंग्रजीतून फ्रेंचमध्ये मजकूर भाषांतरित करण्याचे कार्य विचारात घ्या. "You like this course" हे इनपुट दिल्यास, ट्रान्सलेशन मॉडेलला "like" शब्दाचे योग्य भाषांतर करण्यासाठी त्याच्या लगतच्या "You" या शब्दाकडे देखील लक्ष (attend) द्यावे लागेल, कारण फ्रेंचमध्ये "like" हे क्रियापद कर्त्यानुसार (subject) वेगळ्या प्रकारे चालवले जाते. मात्र, वाक्याचा उरलेला भाग त्या शब्दाच्या भाषांतरासाठी उपयोगी नाही. त्याचप्रमाणे, "this" चे भाषांतर करताना मॉडेलला "course" या शब्दाकडे देखील लक्ष द्यावे लागेल, कारण "this" चे भाषांतर निगडीत नाम (noun) पुल्लिंगी आहे की स्त्रीलिंगी यावर अवलंबून बदलते. पुन्हा, वाक्यातील इतर शब्दांचा "course" च्या भाषांतरासाठी काहीही फरक पडणार नाही. अधिक गुंतागुंतीच्या वाक्यांसह (आणि अधिक गुंतागुंतीच्या व्याकरणाच्या नियमांसह), मॉडेलला प्रत्येक शब्दाचे योग्य भाषांतर करण्यासाठी वाक्यात दूरवर असलेल्या शब्दांवर विशेष लक्ष द्यावे लागेल.
+
+हीच संकल्पना नैसर्गिक भाषेशी (natural language) संबंधित कोणत्याही कार्याला लागू होते: शब्दाचा स्वतःचा एक अर्थ असतो, परंतु तो अर्थ संदर्भाने (context) खूप प्रभावित होतो, जो अभ्यासल्या जात असलेल्या शब्दाच्या आधीचा किंवा नंतरचा कोणताही अन्य शब्द (किंवा शब्द) असू शकतो.
+
+आता तुम्हाला अटेन्शन लेयर्स म्हणजे काय याची कल्पना आली आहे, तर आपण ट्रान्सफॉर्मर आर्किटेक्चर अधिक जवळून पाहूया.
+
+मूळ आर्किटेक्चर (The original architecture)[[the-original-architecture]]
+ट्रान्सफॉर्मर आर्किटेक्चर मूळतः भाषांतरासाठी डिझाइन केले गेले होते. प्रशिक्षणादरम्यान, एन्कोडरला एका विशिष्ट भाषेत इनपुट (वाक्ये) मिळतात, तर डिकोडरला तीच वाक्ये अपेक्षित लक्ष्य भाषेत (target language) मिळतात. एन्कोडरमध्ये, अटेन्शन लेयर्स वाक्यातील सर्व शब्द वापरू शकतात (कारण, आपण आत्ताच पाहिल्याप्रमाणे, एखाद्या शब्दाचे भाषांतर त्याच्या आधी तसेच नंतर काय आहे यावर अवलंबून असू शकते). मात्र, डिकोडर अनुक्रमे (sequentially) कार्य करतो आणि त्याने आधीच भाषांतरित केलेल्या वाक्यातील शब्दांवरच लक्ष देऊ शकतो (म्हणजेच, सध्या जनरेट होत असलेल्या शब्दाच्या आधीच्या शब्दांवरच). उदाहरणार्थ, जेव्हा आपण अनुवादित लक्ष्याचे पहिले तीन शब्द शोधतो (predict करतो), तेव्हा आपण ते डिकोडरला देतो जो नंतर चौथा शब्द शोधण्याचा प्रयत्न करण्यासाठी एन्कोडरचे सर्व इनपुट्स वापरतो.
+
+प्रशिक्षणादरम्यान वेगाने काम करण्यासाठी (जेव्हा मॉडेलला टार्गेट वाक्यांचा अॅक्सेस असतो), डिकोडरला संपूर्ण टार्गेट दिले जाते, परंतु त्याला भविष्यातील शब्द वापरण्याची परवानगी नसते (जर त्याला २ रा शब्द शोधताना २ ऱ्या स्थानावरील शब्दाचा अॅक्सेस मिळाला, तर ही समस्या फार अवघड राहणार नाही!). उदाहरणार्थ, चौथा शब्द शोधण्याचा प्रयत्न करताना, अटेन्शन लेयरला फक्त १ ते ३ स्थानांवरील शब्दांचाच अॅक्सेस असेल.
+
+मूळ ट्रान्सफॉर्मर आर्किटेक्चर डावीकडे एन्कोडर आणि उजवीकडे डिकोडरसह असे दिसत होते:
+
+लक्षात घ्या की डिकोडर ब्लॉकमधील पहिला अटेन्शन लेयर डिकोडरच्या सर्व (मागील) इनपुट्सकडे लक्ष देतो, परंतु दुसरा अटेन्शन लेयर एन्कोडरचे आउटपुट वापरतो. त्यामुळे तो सध्याचा शब्द उत्तम प्रकारे शोधण्यासाठी (predict करण्यासाठी) संपूर्ण इनपुट वाक्याचा अॅक्सेस मिळवू शकतो. हे खूप उपयुक्त आहे कारण वेगवेगळ्या भाषांमध्ये व्याकरणाचे नियम असू शकतात जे शब्दांना वेगवेगळ्या क्रमाने ठेवतात किंवा वाक्यात नंतर दिलेला काही संदर्भ एखाद्या शब्दाचे सर्वोत्तम भाषांतर ठरवण्यासाठी उपयुक्त ठरू शकतो.
+
+एन्कोडर/डिकोडरमध्ये मॉडेलला काही विशेष शब्दांकडे लक्ष देण्यापासून रोखण्यासाठी अटेन्शन मास्क (attention mask) देखील वापरला जाऊ शकतो -- उदाहरणार्थ, वाक्ये एकत्र बॅच (batch) करताना सर्व इनपुट्स समान लांबीचे करण्यासाठी वापरलेला विशेष पॅडिंग (padding) शब्द.
+
+आर्किटेक्चर्स वि. चेकपॉइंट्स (Architectures vs. checkpoints)[[architecture-vs-checkpoints]]
+जसजसे आपण या कोर्समध्ये ट्रान्सफॉर्मर मॉडेल्सबद्दल खोलवर जाणून घेऊ, तसतसे तुम्हाला आर्किटेक्चर्स (architectures) आणि चेकपॉइंट्स (checkpoints) तसेच मॉडेल्स चे संदर्भ दिसतील. या सर्व संज्ञांचे अर्थ थोडे वेगळे आहेत:
+
+आर्किटेक्चर (Architecture): हा मॉडेलचा सांगाडा (skeleton) आहे -- प्रत्येक लेयरची व्याख्या आणि मॉडेलमध्ये होणारी प्रत्येक क्रिया (operation).
+
+चेकपॉइंट्स (Checkpoints): हे असे वेट्स (weights) आहेत जे दिलेल्या आर्किटेक्चरमध्ये लोड केले जातील.
+
+मॉडेल (Model): ही एक सर्वसमावेशक (umbrella) संज्ञा आहे जी "आर्किटेक्चर" किंवा "चेकपॉइंट" इतकी अचूक नाही: याचा अर्थ दोन्ही असू शकतो. संदिग्धता कमी करण्यासाठी जेव्हा महत्त्वाचे असेल तेव्हा हा कोर्स आर्किटेक्चर किंवा चेकपॉइंट नमूद करेल.
+
+उदाहरणार्थ, BERT हे एक आर्किटेक्चर आहे तर bert-base-cased (जे BERT च्या पहिल्या रिलीझसाठी गुगल टीमने प्रशिक्षित केलेल्या वेट्सचा संच आहे) हा एक चेकपॉइंट आहे. तथापि, कोणीही "BERT मॉडेल" आणि "bert-base-cased मॉडेल" असे म्हणू शकतो.
\ No newline at end of file
diff --git a/chapters/mr/chapter 1/5.mdx b/chapters/mr/chapter 1/5.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/6.mdx b/chapters/mr/chapter 1/6.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/7.mdx b/chapters/mr/chapter 1/7.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/8.mdx b/chapters/mr/chapter 1/8.mdx
new file mode 100644
index 000000000..e69de29bb
diff --git a/chapters/mr/chapter 1/9.mdx b/chapters/mr/chapter 1/9.mdx
new file mode 100644
index 000000000..e69de29bb